编辑更新:2026 年 8 月 21 日。数值基准快照的最后一次审核日期为 2026 年 6 月 8 日; 8 月 21 日重新检查了源可达性、模型页面新鲜度和 DeepSeek 技术报告。在做出购买或迁移决定之前验证实时排行榜。
如果您搜索 LLM 基准分数 2026 编码数学推理比较,简短的版本是这样的:在选择模型之前将基准与任务进行匹配,然后验证源日期、支架和成功指标。
编码错误修复、算法竞赛、数学推理和终端代理工作流程不再由同一记分板来衡量。 GPT-5.5、Claude Opus 5、Gemini 3.1 Pro 和 DeepSeek V3.2 都出现在不同的源上下文中。有用的举措是比较适合该工作的正确基准。
您应该使用哪个 LLM 基准?
使用 SWE-bench 进行真正的存储库修复,使用 Aider Polyglot 提高代码编辑质量,使用 LiveCodeBench 进行算法编码,使用 Terminal-Bench 进行 shell 密集型代理工作。没有任何一个基准可以证明某个模型最适合每个开发工作流程,因此请选择与您的团队实际运行的任务最匹配的测试。
| 如果您需要评估 | 开始于 | 然后验证 |
|---|---|---|
| 仓库错误修复和补丁 | SWE-bench 已验证 | 脚手架、测试策略和工具权限 |
| 在 IDE 中编辑多文件 | Aider Polyglot | 成本、差异质量和审核负担 |
| 算法和新的编码问题 | LiveCodeBench | 污染控制和任务难度 |
| 自主终端工作 | Terminal-Bench | 沙盒、重试和人工审批门 |
2026 年 LLM 编码基准:快速地图
LLM 编码基准一词涵盖了几种不同的测试。 SWE-bench 衡量真实的仓库错误修复情况,Aider 衡量多语言编辑质量,LiveCodeBench 衡量编程挑战性能,Terminal-Bench 衡量命令行代理执行情况。
这就是为什么有用的 LLM 编码基准 2026 比较不应将所有内容都归为一个分数。首先将基准测试与您的工作流程进行匹配,然后在该上下文中比较 GPT、Claude、Gemini、DeepSeek 和开放模型结果。
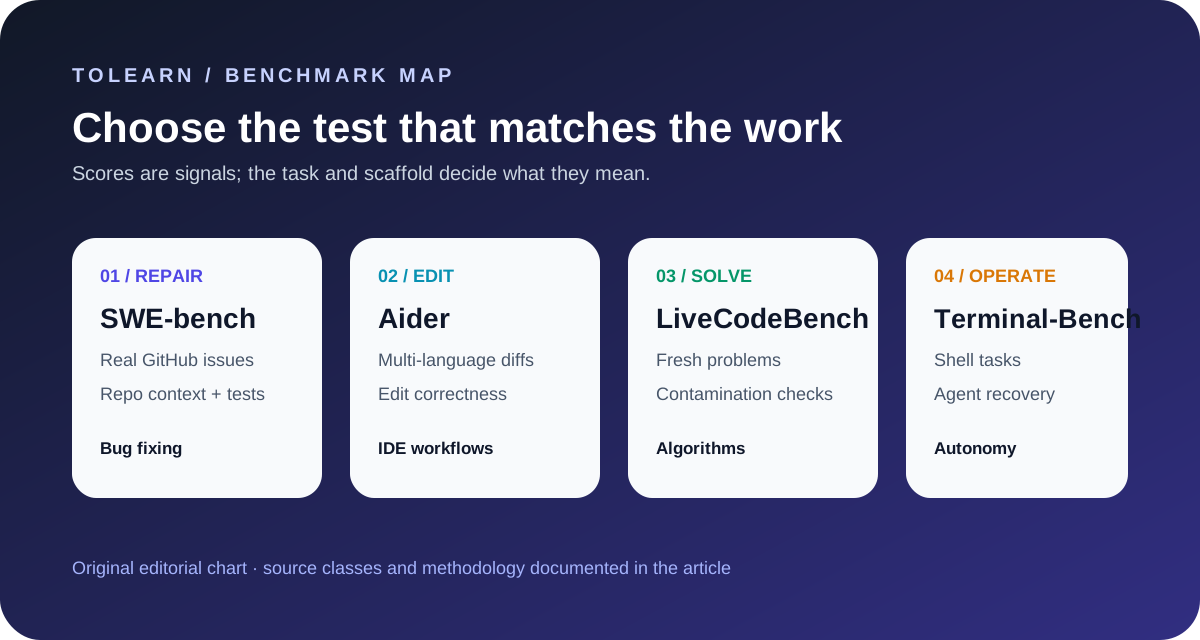
原始图表:ToLearn 将基准系列与他们实际测量的工作流程的编辑映射。
2026 年当前LLM基准分数
此快照将公共排行榜与供应商报告的发布指标分开。这种区别很重要:原始模型、编码代理和 IDE 助手即使使用相同的底层模型,也可能会发布截然不同的分数。
| 模型或排行榜条目 | 编码分数 | 数学/推理分数 | 最佳读数 | 来源 | 来源类型 |
|---|---|---|---|---|---|
| GPT-5.5 | SWE-Bench Pro:58.6%;终端工作台 2.0:82.7% | FrontierMath 第 1-3 级:51.7%;第 4 级:35.4% | OpenAI 发布数据中代理终端工作流程和硬科学推理的最强信号 | OpenAI GPT-5.5 | 供应商报告 |
| 克劳德作品5 | 最新的人择前沿编码和代理模型;此快照中没有记录可比较的公共分数 | 在实时模型页面上验证当前上下文和评估详细信息 | 当前的 Anthropic 模型页面参考;不要将定性模型页面视为跨供应商基准分数 | 人类克劳德作品 | 供应商/模型页面 |
| Gemini 3.1 专业版 | 最新Gemini 3系列模型卡 | 原生多模态推理模型 | 最佳评价为多模态推理和长上下文模型;当确切的任务分数很重要时,使用公共编码排行榜 | 谷歌 DeepMind Gemini 3.1 专业版 | 供应商/模型卡 |
| DeepSeek V3.2 | SWE 基准验证:70.0% 已解决 | GPQA 钻石级:82.4%; MMLU-Pro:85.0% | 强大的以价值为导向的推理和编码竞争者,特别是当成本很重要时 | DeepSeek V3.2模型卡 | 模型卡 |
| Aider 多语言排行榜 | GPT-5高:88.0%; GPT-5培养基:86.7%;Gemini 2.5 Pro:83.1%; DeepSeek V3.2 Reasoner:74.2% | 不是数学基准 | 最适合现实世界的代码编辑和差异质量 | 助手排行榜 | 第三者 |
| SWE-bench 公开快照 | 已验证的报告 % 已解决 超过 500 项任务 | 不是数学基准 | 最适合真正的 GitHub 问题修复;当前顶级公开条目包括 Claude-family、Gemini 3、GPT-5.2 Codex、Kimi K2.5 和 DeepSeek V3.2 变体 | SWE-bench | 第三者 |
标题:GPT-5.5 是最强大的终端和科学推理发射数据故事; Claude Opus 5 是用于代理编码的最新 Anthropic 模型; Gemini 3.1 Pro是谷歌最新的多模态推理模型; DeepSeek V3.2 是值得关注的价值模型。 如需更广泛的存档路径,请参阅 AI 模型比较主题中心 和我们的 AI 代理工具比较 了解工作流程级别的选择。
编码基准分数
编码基准分为三个有用的系列:
| 基准 | 它测试什么 | 最佳使用 |
|---|---|---|
| SWE 工作台验证 | 真正的 GitHub 问题、存储库理解、补丁、测试 | 错误修复和生产型编码代理 |
| Aider Polyglot | 多语言代码编辑和差异正确性 | IDE 和补丁工作流程 |
| LiveCodeBench | 不断刷新竞技编程题 | 算法编码和抗污染问题解决 |
| Terminal-Bench | 命令行任务和代理执行 | 大量 Shell 自主工作流程 |
SWE-bench:真实存储库修复
SWE-bench 仍然是真正的错误修复能力最重要的公共基准,因为它评估系统是否可以解决实际的存储库问题。公共排行榜报告 % Resolved,而不是通用的“编码智商”分数。
这种区别很重要。高 SWE 基准条目通常反映模型及其周围的支架:检索、文件编辑、工具调用、测试执行、重试策略和补丁验证。这就是为什么 Claude 系列模型、Gemini 3 条目、GPT-5.2 Codex 条目、Kimi K2.5 和 DeepSeek 变体都可以出现在同一个公共生态系统中,而无需产生简单的仅模型排名。
如果您的工作流程接近“修复此存储库中的实际错误”,那么 SWE-bench 是正确的起点。如果您的工作流程是“在我的 IDE 中彻底编辑此文件”,Aider 通常更有用。
Aider 多语言:编辑质量
Aider 排行榜 特别有用,因为它测试模型是否可以跨编程语言生成可用的编辑。截至本次刷新,值得注意的行是:
| 模型 | 正确百分比 | Aider 运行的成本 | 它意味着什么 |
|---|---|---|---|
| GPT-5 高 | 88.0% | $29.08 | 此排行榜中高精度编辑的最佳信号 |
| GPT-5培养基 | 86.7% | $17.69 | 以更低的成本实现几乎同样的强度 |
| Gemini 2.5 Pro预览版05-06 | 83.1% | 各不相同 | 来自 Google 上一代的强大编辑基线 |
| DeepSeek V3.2 推理机 | 74.2% | $1.30 | 强大的性价比 |
这就是为什么我不会将“最佳编码模型”视为一项普遍主张。如果您正在进行大量补丁工作,GPT-5 风格的 Aider 结果很重要。如果您正在进行自主回购修复,SWE-bench 和您的代理脚手架更重要。
对于实际操作的 OpenAI 工作流程策略,较旧但仍然有用的姊妹篇是 GPT-5 for Coding: Benchmarks, Pricing & 5 Pro Tips。
LiveCodeBench:算法和抗污染性
LiveCodeBench 很有价值,因为它不断增加编程问题,与静态基准相比,可以降低训练集污染风险。
在当前选定的公共窗口(2024年8月1日至2025年5月1日)中,强势条目包括o4-mini high、Gemini 2.5 Pro 06-05、o3 high、DeepSeek-R1-0528和Qwen3变体。这并不意味着这些人是最好的生产编码助手。这意味着他们在该发布窗口中擅长竞争性编程风格的生成。
当您的问题是“哪种模型解决算法编码问题?”时,请使用 LiveCodeBench。当您的问题是“哪个模型可以正确更改我的代码库?”时,请使用 SWE-bench 或 Aider。
数学和科学推理分数
数学和科学推理现在与一般编码分开进行比较。
GPT-5.5 的发布数据报告 FrontierMath Tier 1-3 为 51.7%,FrontierMath Tier 4 为 35.4%,而 SWE-Bench Pro 为 58.6%。这些数字表明模型针对艰苦的、多步骤的科学和代理工作进行了优化,而不仅仅是简短的编码提示。
DeepSeek V3.2 的技术报告和模型卡报告 在 GPQA Diamond 上为 82.4%,在 MMLU-Pro 上为 85.0%。相同的模型卡证据列出在 SWE 基准验证上解决了 70.0%,而技术报告使用单独的内部代码代理框架来获得更高的内部 SWE 验证结果。这使得 DeepSeek 更难被视为仅限预算的选项,但不得合并两种评估设置。部署、延迟、工具使用和数据策略仍然很重要。
Gemini 3.1 Pro 应被解读为来自 Google 最新 Gemini 3 代的原生多模态推理模型。如果您的数学工作流程包括图表、视觉上下文、长文档或多模式输入,则纯文本排行榜比较将错过部分图片。这里的实用配套文章是Gemini Deep Thinking API:构建数学人工智能应用程序。
代理和终端工作流程分数
代理编码与自动完成不同。
Terminal-Bench、SWE-Bench Pro 和真实的编码代理评估询问模型是否可以跟踪任务、使用工具、检查输出、从错误中恢复并完成有用的工作。 GPT-5.5 的 82.7% Terminal-Bench 2.0 数字是该类别的一个强烈信号。
Claude Opus 5 在这里也很重要,因为 Anthropic 的实时模型页面现在将其列在旧 Opus 条目之上。该页面应被视为当前产品参考,而不是替代可比较的第三方基准行。
这也是工具选择很重要的地方。光标、Claude Code、Codex 风格的终端代理和自定义脚手架都可以更改结果。相关的问题不仅仅是“哪种模型?”但是“哪个模型在哪个工作流程中?”对于这背后的生产力陷阱,请阅读 AI 编码工具:尽管感觉更快,但速度却慢了 19%。
自 2026 年 2 月以来发生的变化
本文的 2 月版本将 Claude Opus 4.5、GPT-5.2、Gemini 2.5 Pro 和 DeepSeek V3.1 作为中心比较集。对于 2026 年基准页面来说,这已经不够新鲜了。
以下是 2026 年 6 月的更新:
| 二月框架 | 2026 年 6 月刷新 |
|---|---|
| Claude Opus 4.5 作为高级编码领导者 | Claude Opus 5 现已被列为当前编码和代理的人类前沿模型 |
| GPT-5.2作为主要的OpenAI推理模型 | GPT-5.5 现在锚定 OpenAI 终端和科学推理基准的比较 |
| Gemini 2.5 Pro 作为上下文窗口的故事 | Gemini 3.1 Pro是当前Google模型卡的目标;单独验证 Anthropic 的实时上下文声明 |
| DeepSeek V3.1 作为价值竞争者 | DeepSeek V3.2 和 V3.2-Speciale 现在是相关推理/编码参考 |
| 一项“最佳模型”声明 | SWE-bench、Aider、LiveCodeBench、Terminal-Bench 和数学推理之间的特定任务比较 |
开放模型的故事也发生了变化。 Kimi K2.5、Qwen、GLM、MiniMax 和 DeepSeek 条目现在经常出现在公共排行榜中,因此它们应该被视为真实选项,而不是好奇心。 Moonshot 角度在 Verbose AI Beats Fast AI: Moonshot K2 $1,172 Paradox 中单独介绍。
您应该使用哪种模型?
| 使用案例 | 最佳起点 | 为什么 |
|---|---|---|
| 真正的仓库错误修复 | Claude-family 或 Gemini/GPT 系统具有强大的 SWE-bench 支架结果 | SWE-bench 奖励存储库理解、测试和补丁验证 |
| 大量补丁的 IDE 编辑 | Aider 风格工作流程中的 GPT-5 高/中 | Aider 强调清晰的差异和多语言编辑 |
| 终端密集型自主工作 | GPT-5.5 或 Claude Opus 5 风格代理设置 | 终端工作台和代理启动定位比自动完成更重要 |
| 数学和科学推理 | GPT-5.5、DeepSeek V3.2-Speciale、Gemini 3.1 Pro | 结合使用 FrontierMath、GPQA、MMLU-Pro 和多模态推理上下文 |
| 预算敏感的编码 | DeepSeek V3.2、Kimi K2.5、Qwen/GLM 系列选项 | 公众评分现在足以证明认真的试点是合理的 |
| 大背景专业工作 | 克劳德 Opus 5 或 Gemini 3.1 Pro | 上下文窗口和多模式/文档处理可以主导原始编码分数 |
对于大多数团队来说,最好的堆栈是混合的:
- 使用快速、便宜的模型进行日常编辑和解释。
- 对硬错误、架构和多步骤代理运行使用更强大的推理模型。
- 通过测试、审查和可观察性来验证每个模型的输出。
- 每月重新检查基准数据,因为公共排行榜的变化速度可能快于您的采购周期。
基准警告
方法论和来源层
此页面上的每个分数均按源类别标记:供应商报告的发布数据、第三方排行榜数据或公共基准快照。供应商结果有助于了解制造商选择的配置;第三方结果对于跨模型上下文更有用;两者都不能保证存储库的性能。
对于每一行,审核都会记录模型版本、数据集或排行榜日期、支架、工具访问、成功指标以及结果是否可以重现。 AI 基准方法指南 包含完整的证据分类账模板和刷新规则。如果来源没有发布可比较的数字,则该表有意使用定性标签而不是发明分数。
基准分数很有用,但它们本身并不是买家指南。
脚手架会改变分数。 SWE-bench 条目通常包括模型和代理系统。检索、文件选择、工具执行、重试和测试工具可以显着改变结果。
Aider、SWE-bench 和 LiveCodeBench 衡量不同的工作。 模型在代码编辑方面可能表现出色,但在实际的仓库错误修复方面则较弱。另一个可以解决算法竞赛,但与混乱的生产代码作斗争。
供应商发布分数和公共排行榜不应盲目合并。 将它们保留在单独的行中,除非任务、数据集和评估工具相同。
延迟和成本在许多总结中是不可见的。 通过大量推理获得较高分数的模型可能是实时 IDE 使用的错误选择。
新鲜度很重要。 2026 年基准文章应指定数据检查日期。如果您阅读此页面时已有一个多月了,请在做出认真的模型决策之前验证最新的排行榜。
底线
最好的 2026 年 LLM 基准比较不是“Claude vs GPT vs Gemini vs DeepSeek”作为单一战斗。这是一张地图:
- GPT-5.5 在 OpenAI 2026 年 6 月发布的终端代理和科学推理任务数据中看起来最强。
- Claude Opus 5 是针对编码、代理和专业工作列出的最新 Anthropic 模型;在进行数值比较之前验证其实时评估细节。
- Gemini 3.1 Pro 是 Google 目前的多模态推理模型卡目标。
- DeepSeek V3.2 是价值竞争者,现在值得认真的编码和推理试点。
- Aider、SWE-bench、LiveCodeBench 和 Terminal-Bench 回答不同的问题,因此请使用与您的工作流程相匹配的基准测试。
如果您只记住一条规则:选择看起来像您的实际任务的基准,然后选择模型。