การอัปเดตด้านบรรณาธิการ: 21 สิงหาคม 2026 สแนปชอตการวัดประสิทธิภาพเชิงตัวเลขได้รับการตรวจสอบครั้งล่าสุดเมื่อวันที่ 8 มิถุนายน 2026 ความสามารถในการเข้าถึงแหล่งที่มา ความใหม่ของหน้าโมเดล และรายงานทางเทคนิคของ DeepSeek ได้รับการตรวจสอบอีกครั้งในวันที่ 21 สิงหาคม ตรวจสอบกระดานผู้นำแบบเรียลไทม์ก่อนตัดสินใจซื้อหรือย้ายข้อมูล
หากคุณค้นหา การเปรียบเทียบคะแนนการวัดประสิทธิภาพ LLM ปี 2026 การเปรียบเทียบการใช้เหตุผลทางคณิตศาสตร์ในการเขียนโค้ด เวอร์ชันย่อคือ: จับคู่เกณฑ์มาตรฐานกับงานก่อนที่จะเลือกแบบจำลอง จากนั้นตรวจสอบวันที่แหล่งที่มา พื้นฐาน และตัวชี้วัดความสำเร็จ
การแก้ไขข้อบกพร่องในการเขียนโค้ด การแข่งขันอัลกอริทึม การให้เหตุผลทางคณิตศาสตร์ และเวิร์กโฟลว์ตัวแทนเทอร์มินัลจะไม่ถูกวัดด้วยกระดานคะแนนเดียวกันอีกต่อไป GPT-5.5, Claude Opus 5, Gemini 3.1 Pro และ DeepSeek V3.2 ล้วนปรากฏในบริบทแหล่งที่มาที่แตกต่างกัน การดำเนินการที่เป็นประโยชน์คือการเปรียบเทียบเกณฑ์มาตรฐานที่เหมาะสมสำหรับงาน
คุณควรใช้เกณฑ์มาตรฐาน LLM ใด
ใช้ SWE-bench สำหรับการซ่อมแซมพื้นที่เก็บข้อมูลจริง Aider Polyglot สำหรับคุณภาพการแก้ไขโค้ด LiveCodeBench สำหรับการเข้ารหัสอัลกอริทึม และ Terminal-Bench สำหรับงานตัวแทนที่ใช้เชลล์หนัก ไม่มีเกณฑ์มาตรฐานใดที่จะพิสูจน์ได้ว่าแบบจำลองนั้นดีที่สุดสำหรับทุกขั้นตอนการพัฒนา ดังนั้นให้เลือกการทดสอบที่ตรงกับงานที่ทีมของคุณจะดำเนินการจริงมากที่สุด
| หากจำเป็นต้องประเมิน | เริ่มต้นด้วย | จากนั้นตรวจสอบ |
|---|---|---|
| การแก้ไขข้อบกพร่องและแพทช์ Repo | ตรวจสอบ SWE-bench แล้ว | การสนับสนุน นโยบายการทดสอบ และการอนุญาตเครื่องมือ |
| การแก้ไขหลายไฟล์ใน IDE | Aider Polyglot | ต้นทุน คุณภาพที่แตกต่าง และภาระการตรวจสอบ |
| อัลกอริทึมและปัญหาการเขียนโค้ดใหม่ | LiveCodeBench | การควบคุมการปนเปื้อนและความยากของงาน |
| งานเทอร์มินัลอัตโนมัติ | Terminal-Bench | Sandbox การลองใหม่ และประตูการอนุมัติจากมนุษย์ |
เกณฑ์มาตรฐานการเข้ารหัส LLM ปี 2026: แผนที่ด่วน
วลี การวัดประสิทธิภาพการเข้ารหัส LLM ครอบคลุมการทดสอบต่างๆ มากมาย SWE-bench วัดการแก้ไขข้อบกพร่องของ repo จริง Aider วัดคุณภาพการแก้ไขหลายภาษา LiveCodeBench วัดประสิทธิภาพความท้าทายในการเขียนโปรแกรม และ Terminal-Bench วัดการดำเนินการของตัวแทนบรรทัดคำสั่ง
นั่นคือเหตุผลที่การเปรียบเทียบ LLM เกณฑ์มาตรฐานการเขียนโค้ดปี 2026 ที่เป็นประโยชน์ไม่ควรรวมทุกอย่างเป็นคะแนนเดียว จับคู่เกณฑ์มาตรฐานกับขั้นตอนการทำงานของคุณก่อน จากนั้นจึงเปรียบเทียบผลลัพธ์ของ GPT, Claude, Gemini, DeepSeek และโมเดลแบบเปิดภายในบริบทนั้น
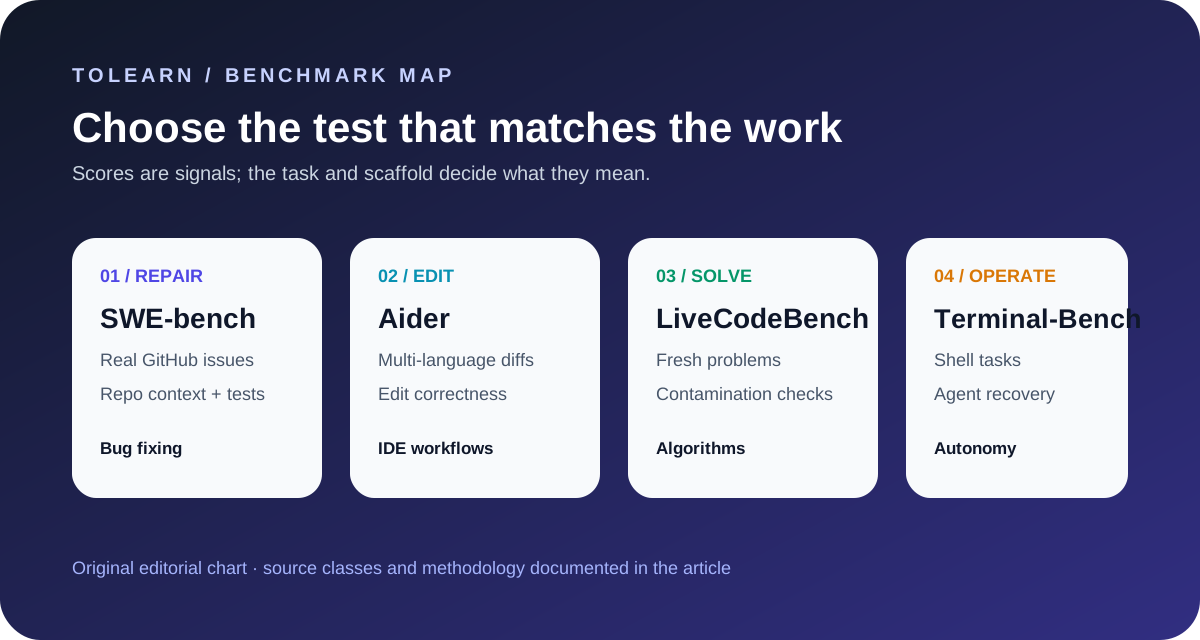
แผนภูมิต้นฉบับ: การจับคู่กลุ่มเกณฑ์มาตรฐานของ ToLearn กับขั้นตอนการทำงานที่พวกเขาวัดจริง
คะแนนมาตรฐาน LLM ปัจจุบันปี 2026
สแน็ปช็อตนี้จะแยกกระดานผู้นำสาธารณะออกจากเมตริกการเปิดตัวที่ผู้ขายรายงาน ความแตกต่างนั้นมีความสำคัญ: โมเดลดิบ เอเจนต์การเขียนโค้ด และผู้ช่วย IDE สามารถโพสต์คะแนนที่แตกต่างกันมาก แม้ว่าจะใช้โมเดลพื้นฐานเดียวกันก็ตาม
| รายการโมเดลหรือลีดเดอร์บอร์ด | คะแนนการเข้ารหัส | คะแนนคณิตศาสตร์ / การใช้เหตุผล | การอ่านที่ดีที่สุด | แหล่งที่มา | ประเภทแหล่งที่มา |
|---|---|---|---|---|---|
| GPT-5.5 | SWE-Bench Pro: 58.6%; Terminal-Bench 2.0: 82.7% | FrontierMath ระดับ 1-3: 51.7%; ระดับ 4: 35.4% | สัญญาณที่ชัดเจนที่สุดสำหรับเวิร์กโฟลว์เทอร์มินัลเอเจนต์และการให้เหตุผลเชิงวิทยาศาสตร์อย่างหนักในข้อมูลที่เผยแพร่ของ OpenAI | OpenAI GPT-5.5 | รายงานผู้ขาย |
| โคลดบทประพันธ์ 5 | การเข้ารหัสและโมเดลตัวแทน Anthropic Frontier ล่าสุด ไม่มีคะแนนสาธารณะที่เทียบเคียงได้บันทึกไว้ในภาพรวมนี้ | ตรวจสอบบริบทปัจจุบันและรายละเอียดการประเมินในหน้าโมเดลสด | การอ้างอิงหน้าโมเดลมานุษยวิทยาปัจจุบัน อย่าถือว่าหน้าโมเดลเชิงคุณภาพเป็นคะแนนมาตรฐานข้ามผู้จำหน่าย | บทประพันธ์มานุษยวิทยาคลอดด์ | หน้าผู้ขาย/รุ่น |
| ราศีเมถุน 3.1 โปร | การ์ดโมเดล Gemini 3 ล่าสุด | แบบจำลองการใช้เหตุผลหลายรูปแบบแบบเนทีฟ | ประเมินได้ดีที่สุดว่าเป็นการใช้เหตุผลหลายรูปแบบและแบบจำลองบริบทยาว ใช้ลีดเดอร์บอร์ดการเข้ารหัสสาธารณะเมื่อคะแนนงานที่แน่นอนมีความสำคัญ | Google DeepMind ราศีเมถุน 3.1 Pro | บัตรผู้ขาย/รุ่น |
| DeepSeek V3.2 | ตรวจสอบ SWE-bench แล้ว: แก้ไขแล้ว 70.0% | GPQA Diamond: 82.4%; MMLU-Pro: 85.0% | คู่แข่งด้านการเขียนโค้ดและการให้เหตุผลเชิงมูลค่าที่แข็งแกร่ง โดยเฉพาะอย่างยิ่งเมื่อต้นทุนมีความสำคัญ | การ์ดรุ่น DeepSeek V3.2 | การ์ดโมเดล |
| ลีดเดอร์บอร์ด Aider Polyglot | GPT-5 สูง: 88.0%; สื่อ GPT-5: 86.7%; ราศีเมถุน 2.5 โปร: 83.1%; เหตุผล DeepSeek V3.2: 74.2% | ไม่ใช่เกณฑ์มาตรฐานทางคณิตศาสตร์ | ดีที่สุดสำหรับการแก้ไขโค้ดในโลกแห่งความเป็นจริงและคุณภาพที่แตกต่าง | กระดานผู้นำ Aider | บุคคลที่สาม |
| ภาพรวมสาธารณะของ SWE-bench | รายงานที่ตรวจสอบแล้ว % แก้ไขแล้ว มากกว่า 500 งาน | ไม่ใช่เกณฑ์มาตรฐานทางคณิตศาสตร์ | ดีที่สุดสำหรับการซ่อมแซมปัญหา GitHub จริง รายการสาธารณะยอดนิยมในปัจจุบัน ได้แก่ Claude-family, Gemini 3, GPT-5.2 Codex, Kimi K2.5 และ DeepSeek V3.2 | SWE-ม้านั่ง | บุคคลที่สาม |
หัวข้อข่าว: GPT-5.5 เป็นเรื่องราวข้อมูลการเปิดตัวที่แข็งแกร่งที่สุดสำหรับเทอร์มินัลและการให้เหตุผลทางวิทยาศาสตร์ Claude Opus 5 เป็นโมเดล Anthropic ใหม่ล่าสุดที่อยู่ในรายการสำหรับการเข้ารหัสแบบเอเจนต์ Gemini 3.1 Pro คือโมเดลการให้เหตุผลหลายรูปแบบล่าสุดของ Google; DeepSeek V3.2 เป็นโมเดลคุณค่าที่น่าจับตามอง สำหรับเส้นทางการเก็บถาวรที่กว้างขึ้น โปรดดูที่ ศูนย์กลางหัวข้อการเปรียบเทียบโมเดล AI และ การเปรียบเทียบเครื่องมือตัวแทน AI ของเราสำหรับตัวเลือกระดับเวิร์กโฟลว์
คะแนนเกณฑ์มาตรฐานการเข้ารหัส
มาตรฐานการเข้ารหัสแบ่งออกเป็นสามตระกูลที่มีประโยชน์:
| เกณฑ์มาตรฐาน | มันทดสอบอะไร | ใช้ดีที่สุด |
|---|---|---|
| SWE-ม้านั่งตรวจสอบแล้ว | ปัญหา GitHub จริง, ความเข้าใจ repo, แพตช์, การทดสอบ | การแก้ไขข้อบกพร่องและเอเจนต์การเขียนโค้ดสไตล์การผลิต |
| ไอเดอร์ พูดได้หลายภาษา | การแก้ไขโค้ดหลายภาษาและความถูกต้องต่างกัน | IDE และแพทช์เวิร์กโฟลว์ |
| LiveCodeBench | รีเฟรชปัญหาการเขียนโปรแกรมการแข่งขันอย่างต่อเนื่อง | การเข้ารหัสอัลกอริธึมและการแก้ปัญหาการปนเปื้อน |
| เทอร์มินัล-ม้านั่ง | งานบรรทัดคำสั่งและการดำเนินการของตัวแทน | เวิร์กโฟลว์อัตโนมัติแบบเชลล์เฮฟวี่ |
SWE-bench: การซ่อมแซมพื้นที่เก็บข้อมูลจริง
SWE-bench ยังคงเป็นเกณฑ์มาตรฐานสาธารณะที่สำคัญที่สุดสำหรับความสามารถในการแก้ไขข้อบกพร่องที่แท้จริง เนื่องจากประเมินว่าระบบสามารถแก้ไขปัญหาพื้นที่เก็บข้อมูลจริงได้หรือไม่ บอร์ดผู้นำสาธารณะรายงาน % ได้รับการแก้ไขแล้ว ไม่ใช่คะแนน "coding IQ" ทั่วไป
ความแตกต่างนั้นสำคัญ รายการ SWE-bench ในระดับสูงมักจะสะท้อนถึงทั้งโมเดลและโครงสร้างโดยรอบ: การดึงข้อมูล การแก้ไขไฟล์ การเรียกเครื่องมือ การดำเนินการทดสอบ นโยบายการลองใหม่ และการตรวจสอบความถูกต้องของแพตช์ นี่คือเหตุผลว่าทำไมโมเดลในตระกูล Claude, รายการ Gemini 3, รายการ Codex GPT-5.2, Kimi K2.5 และตัวแปร DeepSeek ทั้งหมดจึงสามารถปรากฏในระบบนิเวศสาธารณะเดียวกันได้โดยไม่ต้องสร้างการจัดอันดับเฉพาะโมเดลอย่างง่ายๆ
หากเวิร์กโฟลว์ของคุณใกล้เคียงกับ "แก้ไขจุดบกพร่องที่แท้จริงใน repo นี้" SWE-bench คือจุดเริ่มต้นที่ถูกต้อง หากเวิร์กโฟลว์ของคุณ "แก้ไขไฟล์นี้อย่างหมดจดใน IDE ของฉัน" Aider มักจะมีประโยชน์มากกว่า
Aider Polyglot: การแก้ไขคุณภาพ
Aider leaderboard มีประโยชน์อย่างยิ่ง เนื่องจากเป็นการทดสอบว่าโมเดลสามารถสร้างการแก้ไขที่ใช้งานได้ในภาษาการเขียนโปรแกรมหรือไม่ ในการรีเฟรชนี้ แถวที่โดดเด่นคือ:
| แบบอย่าง | ถูกต้องร้อยละ | ต้นทุนในการรัน Aider | มันบ่งบอกอะไร. |
|---|---|---|---|
| GPT-5 สูง | 88.0% | $29.08 | สัญญาณที่ดีที่สุดสำหรับการแก้ไขที่มีความแม่นยำสูงในลีดเดอร์บอร์ดนี้ |
| GPT-5 มีเดียม | 86.7% | $17.69 | เกือบแข็งแกร่งด้วยต้นทุนที่ต่ำกว่า |
| ราศีเมถุน 2.5 Pro ดูตัวอย่าง 05-06 | 83.1% | แตกต่างกันไป | พื้นฐานการแก้ไขที่แข็งแกร่งจากรุ่นก่อนหน้าของ Google |
| เหตุผล DeepSeek V3.2 | 74.2% | $1.30 | โปรไฟล์ความคุ้มค่าต่อต้นทุนที่แข็งแกร่ง |
นี่คือสาเหตุที่ฉันจะไม่อ่าน "โมเดลการเข้ารหัสที่ดีที่สุด" ว่าเป็นการกล่าวอ้างสากลข้อเดียว หากคุณกำลังทำงานหนักในแพตช์ ผลลัพธ์ของ Aider สไตล์ GPT-5 ก็มีความสำคัญ หากคุณกำลังซ่อมแซม repo แบบอัตโนมัติ SWE-bench และโครงข่ายตัวแทนของคุณมีความสำคัญมากกว่า
สำหรับกลยุทธ์เวิร์กโฟลว์ OpenAI ที่ลงมือปฏิบัติจริง ชิ้นส่วนที่เก่ากว่าแต่ยังคงมีประโยชน์คือ GPT-5 for Coding: Benchmarks, Pricing & 5 Pro Tips
LiveCodeBench: อัลกอริทึมและการต้านทานการปนเปื้อน
LiveCodeBench มีคุณค่าเนื่องจากเพิ่มปัญหาการเขียนโปรแกรมอย่างต่อเนื่อง ซึ่งช่วยลดความเสี่ยงในการปนเปื้อนที่กำหนดไว้ในการฝึกอบรมเมื่อเปรียบเทียบกับการวัดประสิทธิภาพแบบคงที่
ในหน้าต่างสาธารณะที่เลือกในปัจจุบัน (1 สิงหาคม 2024 ถึง 1 พฤษภาคม 2025) รายการที่แข็งแกร่ง ได้แก่ o4-mini high, Gemini 2.5 Pro 06-05, o3 high, DeepSeek-R1-0528 และตัวแปร Qwen3 นั่นไม่ได้ ไม่ได้ หมายความว่าสิ่งเหล่านั้นคือผู้ช่วยเขียนโค้ดการผลิตที่ดีที่สุดโดยอัตโนมัติ หมายความว่าพวกเขามีความแข็งแกร่งในการสร้างรูปแบบการเขียนโปรแกรมที่แข่งขันได้ในหน้าต่างที่เผยแพร่นั้น
ใช้ LiveCodeBench เมื่อคำถามของคุณคือ "โมเดลใดที่แก้ปัญหาการเข้ารหัสอัลกอริทึมได้" ใช้ SWE-bench หรือ Aider เมื่อคำถามของคุณคือ "รุ่นใดที่สามารถเปลี่ยน codebase ของฉันได้อย่างถูกต้อง"
คะแนนการใช้เหตุผลทางคณิตศาสตร์และวิทยาศาสตร์
ขณะนี้การใช้เหตุผลทางคณิตศาสตร์และวิทยาศาสตร์เป็นการเปรียบเทียบที่แยกจากการเขียนโค้ดทั่วไป
ข้อมูลการเปิดตัวของ GPT-5.5 รายงาน 51.7% ใน FrontierMath Tier 1-3 และ 35.4% ใน FrontierMath Tier 4 ควบคู่ไปกับ 58.6% ใน SWE-Bench Pro ตัวเลขเหล่านี้ชี้ไปที่แบบจำลองที่ได้รับการปรับให้เหมาะสมสำหรับงานทางวิทยาศาสตร์และตัวแทนที่หนักหน่วงหลายขั้นตอน แทนที่จะเป็นเพียงการแจ้งเตือนการเข้ารหัสแบบสั้นเท่านั้น
รายงานทางเทคนิคและการ์ดโมเดลของ DeepSeek V3.2 82.4% บน GPQA Diamond และ 85.0% บน MMLU-Pro รายการหลักฐานการ์ดโมเดลเดียวกัน 70.0% ได้รับการแก้ไขใน SWE-bench Verified ในขณะที่รายงานทางเทคนิคใช้เฟรมเวิร์ก Code-agent ภายในที่แยกต่างหากสำหรับผลลัพธ์ SWE-Verified ภายในที่สูงกว่า นั่นทำให้ DeepSeek ยากขึ้นมากในการปฏิเสธว่าเป็นตัวเลือกแบบประหยัด แต่การตั้งค่าการประเมินทั้งสองรายการจะต้องไม่ถูกรวมเข้าด้วยกัน การปรับใช้ เวลาแฝง การใช้เครื่องมือ และนโยบายข้อมูลยังคงมีความสำคัญ
Gemini 3.1 Pro ควรอ่านเป็น โมเดลการให้เหตุผลหลายรูปแบบดั้งเดิม จาก Gemini 3 เจนเนอเรชั่นล่าสุดของ Google หากขั้นตอนการทำงานทางคณิตศาสตร์ของคุณมีไดอะแกรม บริบทที่เป็นภาพ เอกสารขนาดยาว หรือการป้อนข้อมูลหลายรูปแบบ การเปรียบเทียบลีดเดอร์บอร์ดแบบข้อความอย่างเดียวจะพลาดบางส่วนของรูปภาพ บทความคู่หูที่ใช้งานได้จริงที่นี่คือ Gemini Deep Thinking API: สร้างแอป AI ทางคณิตศาสตร์
คะแนนเวิร์กโฟลว์ตัวแทนและเทอร์มินัล
การเข้ารหัสตัวแทนไม่เหมือนกับการเติมข้อความอัตโนมัติ
การประเมิน Terminal-Bench, SWE-Bench Pro และเอเจนต์การเขียนโค้ดจริงจะถามว่าโมเดลสามารถติดตามงาน ใช้เครื่องมือ ตรวจสอบเอาต์พุต กู้คืนจากข้อผิดพลาด และทำงานที่เป็นประโยชน์ให้เสร็จสิ้นได้หรือไม่ ตัวเลข 82.7% Terminal-Bench 2.0 ของ GPT-5.5 ถือเป็นสัญญาณที่ชัดเจนสำหรับหมวดหมู่นี้
Claude Opus 5 มีความเกี่ยวข้องที่นี่เช่นกัน เนื่องจากหน้าโมเดลสดของ Anthropic แสดงรายการไว้เหนือรายการ Opus ที่เก่ากว่า หน้านี้ควรถือเป็นข้อมูลอ้างอิงผลิตภัณฑ์ในปัจจุบัน ไม่ใช่เป็นการทดแทนแถวเปรียบเทียบของบุคคลที่สามที่เทียบเคียงได้
การเลือกเครื่องมือก็เป็นสิ่งสำคัญเช่นกัน เคอร์เซอร์, Claude Code, เอเจนต์เทอร์มินัลสไตล์ Codex และโครงแบบกำหนดเองสามารถเปลี่ยนผลลัพธ์ได้ คำถามที่เกี่ยวข้องไม่ใช่แค่ "รุ่นไหน" แต่ "รุ่นไหนอยู่ในเวิร์กโฟลว์ไหน?" หากต้องการทราบกับดักประสิทธิภาพการทำงานเบื้องหลังสิ่งนี้ โปรดอ่าน เครื่องมือการเข้ารหัส AI: ช้าลง 19% แม้จะรู้สึกเร็วขึ้น
สิ่งที่เปลี่ยนแปลงไปตั้งแต่เดือนกุมภาพันธ์ 2569
บทความนี้ในเวอร์ชันเดือนกุมภาพันธ์ถือว่า Claude Opus 4.5, GPT-5.2, Gemini 2.5 Pro และ DeepSeek V3.1 เป็นชุดการเปรียบเทียบกลาง ข้อมูลดังกล่าวไม่สดพอสำหรับหน้าเปรียบเทียบปี 2026 อีกต่อไป
นี่คือการอัปเดตเดือนมิถุนายน 2026:
| การจัดเฟรมเดือนกุมภาพันธ์ | รีเฟรชเดือนมิถุนายน 2569 |
|---|---|
| Claude Opus 4.5 เป็นผู้นำการเขียนโค้ดระดับพรีเมียม | ขณะนี้ Claude Opus 5 ได้รับการจัดอันดับให้เป็นโมเดล Anthropic Frontier สำหรับการเขียนโค้ดและเอเจนต์ในปัจจุบัน |
| GPT-5.2 เป็นโมเดลการให้เหตุผลหลักของ OpenAI | ขณะนี้ GPT-5.5 ยึดการเปรียบเทียบ OpenAI สำหรับเกณฑ์มาตรฐานเทอร์มินัลและเหตุผลทางวิทยาศาสตร์ |
| Gemini 2.5 Pro เป็นเรื่องราวของหน้าต่างบริบท | Gemini 3.1 Pro คือเป้าหมายการ์ดโมเดลของ Google ในปัจจุบัน ตรวจสอบการอ้างบริบทสดของ Anthropic แยกกัน |
| DeepSeek V3.1 เป็นคู่แข่งด้านคุณค่า | DeepSeek V3.2 และ V3.2-Speciale เป็นข้อมูลอ้างอิงการให้เหตุผล/การเขียนโค้ดที่เกี่ยวข้องแล้ว |
| การกล่าวอ้าง "โมเดลที่ดีที่สุด" หนึ่งข้อ | การเปรียบเทียบเฉพาะงานระหว่าง SWE-bench, Aider, LiveCodeBench, Terminal-Bench และการใช้เหตุผลทางคณิตศาสตร์ |
เรื่องราวแบบเปิดก็เปลี่ยนไปเช่นกัน รายการ Kimi K2.5, Qwen, GLM, MiniMax และ DeepSeek ตอนนี้ปรากฏบ่อยเพียงพอในกระดานผู้นำสาธารณะที่ควรถือเป็นตัวเลือกที่แท้จริง ไม่ใช่สิ่งที่อยากรู้ มุม Moonshot ครอบคลุมแยกกันใน Verbose AI Beats Fast AI: Moonshot K2 $1,172 Paradox
คุณควรใช้รุ่นใด?
| กรณีการใช้งาน | จุดเริ่มต้นที่ดีที่สุด | ทำไม |
|---|---|---|
| แก้ไขข้อผิดพลาด repo จริง | ระบบตระกูล Claude หรือ Gemini/GPT พร้อมผลลัพธ์โครงนั่งร้าน SWE-bench ที่แข็งแกร่ง | SWE-bench ให้รางวัลแก่ความเข้าใจ การทดสอบ และการตรวจสอบแพตช์ |
| การแก้ไข IDE ที่ต้องใช้แพตช์หนัก | GPT-5 สูง/ปานกลางในเวิร์กโฟลว์สไตล์ Aider | Aider เน้นความแตกต่างที่ชัดเจนและการแก้ไขหลายภาษา |
| งานอัตโนมัติแบบเทอร์มินัลหนัก | การตั้งค่าเอเจนต์สไตล์ GPT-5.5 หรือ Claude Opus 5 | Terminal-Bench และการวางตำแหน่งการเปิดตัวแบบเอเจนต์มีความสำคัญมากกว่าการเติมข้อความอัตโนมัติ |
| การใช้เหตุผลทางคณิตศาสตร์และวิทยาศาสตร์ | GPT-5.5, DeepSeek V3.2-พิเศษ, Gemini 3.1 Pro | ใช้ FrontierMath, GPQA, MMLU-Pro และบริบทการให้เหตุผลหลายรูปแบบร่วมกัน |
| การเข้ารหัสที่คำนึงถึงงบประมาณ | ตัวเลือก DeepSeek V3.2, Kimi K2.5, Qwen/GLM | ขณะนี้คะแนนสาธารณะแข็งแกร่งพอที่จะพิสูจน์ให้เห็นถึงนักบินที่จริงจัง |
| งานมืออาชีพที่มีบริบทขนาดใหญ่ | Claude Opus 5 หรือ Gemini 3.1 Pro | หน้าต่างบริบทและการจัดการหลายรูปแบบ/เอกสารสามารถครอบงำคะแนนการเขียนโค้ดดิบได้ |
สำหรับทีมส่วนใหญ่ สแต็คที่ดีที่สุดคือไฮบริด:
- ใช้แบบจำลองที่รวดเร็วและถูกกว่าสำหรับการแก้ไขและคำอธิบายตามปกติ
- ใช้โมเดลการให้เหตุผลที่ชัดเจนยิ่งขึ้นสำหรับฮาร์ดบัก สถาปัตยกรรม และการรันเอเจนต์แบบหลายขั้นตอน
- ตรวจสอบความถูกต้องของเอาต์พุตทุกรุ่นด้วยการทดสอบ การทบทวน และความสามารถในการสังเกต
- ตรวจสอบข้อมูลเกณฑ์มาตรฐานอีกครั้งทุกเดือน เนื่องจากกระดานผู้นำสาธารณะสามารถเปลี่ยนแปลงได้เร็วกว่ารอบการจัดซื้อของคุณ
ข้อควรระวังมาตรฐาน
วิธีการและระดับแหล่งที่มา
ทุกคะแนนในหน้านี้ถูกแท็กตามคลาสแหล่งที่มา: ข้อมูลการเปิดตัวที่ผู้ขายรายงาน ข้อมูลลีดเดอร์บอร์ดของบุคคลที่สาม หรือภาพรวมการวัดประสิทธิภาพสาธารณะ ผลลัพธ์ของผู้จำหน่ายมีประโยชน์สำหรับการทำความเข้าใจการกำหนดค่าที่เลือกของผู้ผลิต ผลลัพธ์จากบุคคลที่สามมีประโยชน์มากกว่าสำหรับบริบทข้ามโมเดล และไม่รับประกันประสิทธิภาพในพื้นที่เก็บข้อมูลของคุณ
สำหรับแต่ละแถว การตรวจสอบจะบันทึกเวอร์ชันของโมเดล ชุดข้อมูลหรือวันที่กระดานผู้นำ โครงสร้าง การเข้าถึงเครื่องมือ ตัวชี้วัดความสำเร็จ และพิจารณาว่าสามารถทำซ้ำผลลัพธ์ได้หรือไม่ คู่มือวิธีการวัดประสิทธิภาพ AI มีเทมเพลตบัญชีแยกประเภทหลักฐานฉบับเต็มและกฎการรีเฟรช ในกรณีที่แหล่งที่มาไม่เผยแพร่ตัวเลขที่เทียบเคียงได้ ตารางนี้จงใจใช้ป้ายกำกับเชิงคุณภาพแทนการสร้างคะแนน
คะแนนเปรียบเทียบมีประโยชน์ แต่ก็ไม่ใช่คำแนะนำสำหรับผู้ซื้อเพียงอย่างเดียว
นั่งร้านเปลี่ยนคะแนน รายการ SWE-bench มักจะมีโมเดลบวกกับระบบตัวแทนด้วย การเรียกข้อมูล การเลือกไฟล์ การใช้เครื่องมือ การลองใหม่ และชุดทดสอบสามารถย้ายผลลัพธ์ได้อย่างมาก
Aider, SWE-bench และ LiveCodeBench วัดการทำงานที่แตกต่างกัน โมเดลสามารถแก้ไขโค้ดได้อย่างยอดเยี่ยมและอ่อนแอกว่าในการซ่อมแซมจุดบกพร่องของ repo จริง อีกวิธีหนึ่งสามารถแก้ปัญหาการแข่งขันอัลกอริธึมได้ แต่ต้องต่อสู้กับรหัสการผลิตที่ยุ่งเหยิง
ไม่ควรรวมคะแนนการเปิดตัวของผู้จำหน่ายและกระดานผู้นำสาธารณะแบบสุ่มสี่สุ่มห้า เก็บไว้ในแถวแยกกัน เว้นแต่งาน ชุดข้อมูล และชุดประเมินผลจะเหมือนกัน
ความหน่วงและค่าใช้จ่ายไม่อาจมองเห็นได้ในบทสรุปจำนวนมาก แบบจำลองที่ได้รับคะแนนสูงกว่าพร้อมการให้เหตุผลหนักๆ อาจเป็นทางเลือกที่ผิดสำหรับการใช้งาน IDE แบบเรียลไทม์
ความสดใหม่เป็นสิ่งสำคัญ บทความเปรียบเทียบปี 2026 ควรระบุวันที่ตรวจสอบข้อมูล หากหน้านี้มีอายุมากกว่าหนึ่งเดือนเมื่อคุณอ่าน ให้ตรวจสอบลีดเดอร์บอร์ดล่าสุดก่อนตัดสินใจสร้างโมเดลอย่างจริงจัง
บรรทัดล่าง
การเปรียบเทียบเกณฑ์มาตรฐาน LLM ที่ดีที่สุดในปี 2026 ไม่ใช่ "Claude vs GPT vs Gemini vs DeepSeek" ในการต่อสู้ครั้งเดียว มันคือแผนที่:
- GPT-5.5 ดูแข็งแกร่งที่สุดในข้อมูลการเปิดตัว OpenAI ในเดือนมิถุนายน 2569 สำหรับงาน Terminal-agent และการใช้เหตุผลทางวิทยาศาสตร์
- Claude Opus 5 เป็นโมเดล Anthropic ใหม่ล่าสุดที่ระบุไว้สำหรับการเขียนโค้ด เจ้าหน้าที่ และงานระดับมืออาชีพ ตรวจสอบรายละเอียดการประเมินสดก่อนที่จะเปรียบเทียบเป็นตัวเลข
- Gemini 3.1 Pro คือการ์ดโมเดลเป้าหมายการใช้เหตุผลหลายรูปแบบในปัจจุบันของ Google
- DeepSeek V3.2 เป็นคู่แข่งที่มีคุณค่าซึ่งขณะนี้สมควรได้รับโปรแกรมนำร่องการเขียนโค้ดและการใช้เหตุผลอย่างจริงจัง
- Aider, SWE-bench, LiveCodeBench และ Terminal-Bench ตอบคำถามต่างๆ ดังนั้นใช้เกณฑ์มาตรฐานที่ตรงกับขั้นตอนการทำงานของคุณ
หากคุณจำกฎได้เพียงข้อเดียว: เลือกเกณฑ์มาตรฐานที่ดูเหมือนงานจริงของคุณ จากนั้นเลือกโมเดล