Atualização editorial: 21 de agosto de 2026. Os instantâneos de benchmark numéricos foram revisados pela última vez em 8 de junho de 2026; a acessibilidade da fonte, a atualização da página do modelo e o relatório técnico do DeepSeek foram verificados novamente em 21 de agosto. Verifique as tabelas de classificação ao vivo antes de tomar uma decisão de compra ou migração.
Se você pesquisou LLM benchmark pontuações 2026 codificação raciocínio matemático comparação, a versão resumida é esta: combine o benchmark com a tarefa antes de escolher um modelo e, em seguida, verifique a data de origem, a estrutura e a métrica de sucesso.
Correções de bugs de codificação, concursos de algoritmos, raciocínio matemático e fluxos de trabalho de agentes terminais não são mais medidos pelo mesmo painel de avaliação. GPT-5.5, Claude Opus 5, Gemini 3.1 Pro e DeepSeek V3.2 aparecem em diferentes contextos de origem. A medida útil é comparar o benchmark certo para o trabalho.
Qual benchmark LLM você deve usar?
Use o SWE-bench para reparo de repositório real, o Aider Polyglot para qualidade de edição de código, o LiveCodeBench para codificação algorítmica e o Terminal-Bench para trabalho de agente com uso pesado de shell. Nenhum benchmark prova que um modelo é melhor para cada fluxo de trabalho de desenvolvimento; portanto, escolha o teste que mais se aproxima da tarefa que sua equipe realmente executará.
| Se você precisa avaliar | Comece com | Então verifique |
|---|---|---|
| Correções de bugs e patches de repositório | SWE-bench verificado | Scaffold, política de teste e permissões de ferramentas |
| Edição de vários arquivos em um IDE | Aider Poliglota | Custo, qualidade diferencial e carga de revisão |
| Algoritmos e novos problemas de codificação | LiveCodeBench | Controles de contaminação e dificuldade da tarefa |
| Trabalho terminal autônomo | Terminal-Bench | Sandbox, novas tentativas e portas de aprovação humana |
Benchmarks de codificação LLM 2026: mapa rápido
A frase Benchmarks de codificação LLM abrange vários testes diferentes. SWE-bench mede a correção de bugs de repositório real, Aider mede a qualidade de edição multilíngue, LiveCodeBench mede o desempenho do desafio de programação e Terminal-Bench mede a execução do agente de linha de comando.
É por isso que uma comparação útil do LLM coding benchmark 2026 não deve resumir tudo em uma pontuação. Combine primeiro o benchmark com o seu fluxo de trabalho e, em seguida, compare os resultados de GPT, Claude, Gemini, DeepSeek e modelo aberto dentro desse contexto.
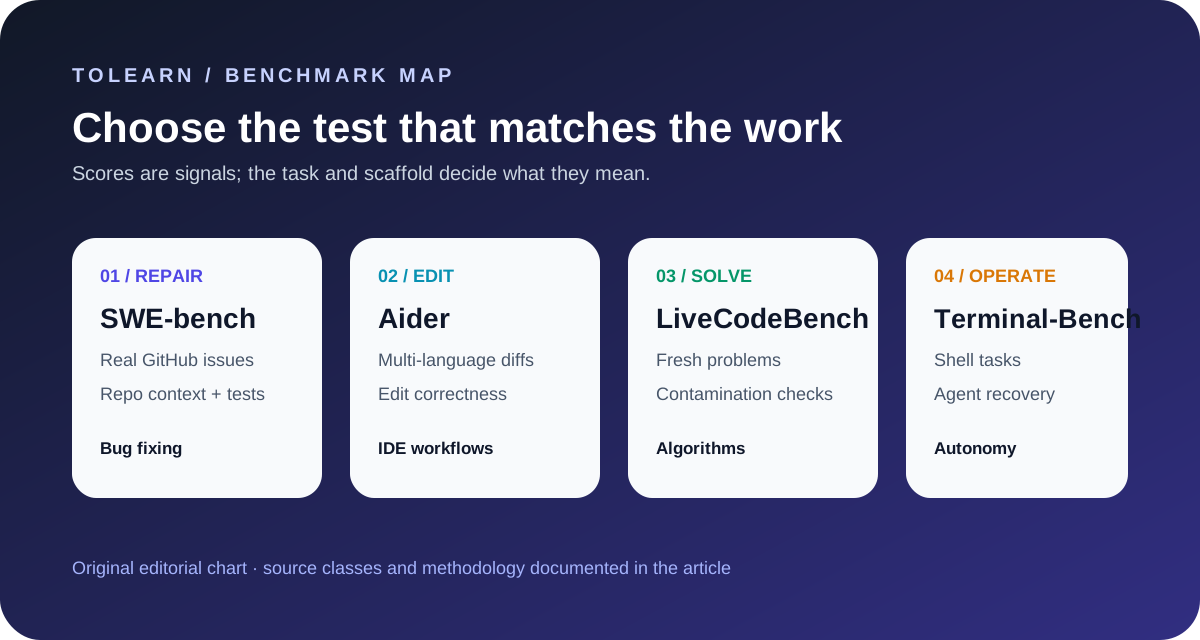
Gráfico original: mapeamento editorial da ToLearn das famílias de benchmark para os fluxos de trabalho que elas realmente medem.
Pontuações atuais de benchmark LLM 2026
Este instantâneo separa os placares públicos das métricas de lançamento relatadas pelo fornecedor. Essa distinção é importante: um modelo bruto, um agente de codificação e um assistente de IDE podem postar pontuações muito diferentes, mesmo quando usam o mesmo modelo subjacente.
| Entrada de modelo ou tabela de classificação | Pontuação de codificação | Pontuação de matemática/raciocínio | Melhor leitura | Fonte | Tipo de fonte |
|---|---|---|---|---|---|
| GPT-5.5 | SWE-Bench Pro: 58,6%; Terminal-bancada 2.0: 82,7% | FrontierMath Nível 1-3: 51,7%; Nível 4: 35,4% | Sinal mais forte para fluxos de trabalho de terminais de agência e raciocínio científico sólido nos dados de lançamento da OpenAI | OpenAI GPT-5.5 | Relatório do fornecedor |
| Cláudio Opus 5 | Último modelo de agente e codificação de fronteira antrópica; nenhuma pontuação pública comparável registrada neste instantâneo | Verifique o contexto atual e os detalhes da avaliação na página do modelo ativo | Referência atual da página modelo da Antrópica; não trate a página do modelo qualitativo como uma pontuação de referência de vários fornecedores | Anthropic Claude Opus | Página do fornecedor/modelo |
| Gemini 3.1 Pró | Placa de modelo mais recente da série Gemini 3 | Modelo de raciocínio multimodal nativo | Melhor avaliado como um raciocínio multimodal e modelo de longo contexto; use tabelas de classificação de codificação pública quando as pontuações exatas das tarefas forem importantes | Google DeepMind Gemini 3.1 Pro | Cartão de fornecedor/modelo |
| DeepSeek V3.2 | SWE-bench verificado: 70,0% resolvido | Diamante GPQA: 82,4%; MMLU-Pro: 85,0% | Forte raciocínio orientado a valor e concorrente de codificação, especialmente quando o custo é importante | Cartão modelo DeepSeek V3.2 | Cartão modelo |
| Tabela de classificação do Aider Polyglot | GPT-5 alto: 88,0%; Meio GPT-5: 86,7%; Gemini 2.5 Pro: 83,1%; Raciocinador do DeepSeek V3.2: 74,2% | Não é uma referência matemática | Melhor para edição de código do mundo real e qualidade de comparação | Tabela de classificação de Aider | Terceiro |
| Instantâneo público do SWE-bench | Relatórios verificados % resolvidos mais de 500 tarefas | Não é uma referência matemática | Melhor para reparo real de problemas do GitHub; As principais entradas públicas atuais incluem variantes Claude-family, Gemini 3, GPT-5.2 Codex, Kimi K2.5 e DeepSeek V3.2 | SWE-bench | Terceiro |
A manchete: GPT-5.5 é a história de dados de lançamento mais forte para raciocínio terminal e científico; Claude Opus 5 é o mais novo modelo Anthropic listado para codificação agente; Gemini 3.1 Pro é o mais recente modelo de raciocínio multimodal do Google; DeepSeek V3.2 é o modelo de valor a ser observado. Para obter um caminho de arquivo mais amplo, consulte o hub de tópicos de comparações de modelos de IA e nossa comparação de ferramentas de agente de IA para opções em nível de fluxo de trabalho.
Pontuações de referência de codificação
Os benchmarks de codificação são divididos em três famílias úteis:
| Referência | O que testa | Melhor uso |
|---|---|---|
| SWE-banco verificado | Problemas reais do GitHub, compreensão do repositório, patches, testes | Correção de bugs e agentes de codificação de estilo de produção |
| Aider Poliglota | Edição de código multilíngue e correção de diferenças | Fluxos de trabalho de IDE e patch |
| LiveCodeBench | Problemas de programação competitiva continuamente atualizados | Codificação algorítmica e solução de problemas resistentes à contaminação |
| Terminal-Banco | Tarefas de linha de comando e execução de agente | Fluxos de trabalho autônomos com muito uso de shell |
SWE-bench: Reparo Real de Repositório
SWE-bench continua sendo o benchmark público mais importante para a capacidade real de correção de bugs porque avalia se um sistema pode resolver problemas reais de repositório. A tabela de classificação pública informa % Resolvido, não uma pontuação genérica de "QI de codificação".
Essa distinção é importante. Uma entrada alta no SWE-bench geralmente reflete tanto o modelo quanto a estrutura em torno dele: recuperação, edição de arquivos, chamadas de ferramentas, execução de testes, política de novas tentativas e validação de patch. É por isso que os modelos da família Claude, entradas Gemini 3, entradas GPT-5.2 Codex, Kimi K2.5 e variantes DeepSeek podem aparecer no mesmo ecossistema público sem produzir uma classificação simples apenas de modelo.
Se o seu fluxo de trabalho estiver próximo de "corrigir esse bug real neste repositório", o SWE-bench é o ponto de partida certo. Se o seu fluxo de trabalho for "editar este arquivo de forma limpa em meu IDE", o Aider geralmente é mais útil.
Aider Polyglot: qualidade de edição
O tabela de classificação do Aider é especialmente útil porque testa se um modelo pode produzir edições utilizáveis em linguagens de programação. A partir desta atualização, as linhas notáveis são:
| Modelo | Porcentagem correta | Custo na execução do Aider | O que isso sugere |
|---|---|---|---|
| GPT-5 alto | 88.0% | $29.08 | Melhor sinal para edições de alta precisão nesta tabela de classificação |
| Meio GPT-5 | 86.7% | $17.69 | Quase tão forte a um custo mais baixo |
| Pré-visualização do Gemini 2.5 Pro 05-06 | 83.1% | Varia | Forte linha de base de edição da geração anterior do Google |
| Raciocínio DeepSeek V3.2 | 74.2% | $1.30 | Forte perfil de valor-custo |
É por isso que eu não interpretaria “melhor modelo de codificação” como uma afirmação universal. Se você estiver realizando um trabalho pesado de patches, os resultados do Aider estilo GPT-5 são importantes. Se você estiver fazendo reparos de recompra autônomos, o SWE-bench e o andaime do seu agente são mais importantes.
Para táticas práticas de fluxo de trabalho OpenAI, a peça complementar mais antiga, mas ainda útil, é GPT-5 para codificação: benchmarks, preços e 5 dicas profissionais.
LiveCodeBench: Algoritmos e Resistência à Contaminação
LiveCodeBench é valioso porque adiciona continuamente problemas de programação, o que reduz o risco de contaminação do conjunto de treinamento em comparação com benchmarks estáticos.
Na janela pública atualmente selecionada (1º de agosto de 2024 a 1º de maio de 2025), as entradas fortes incluem o4-mini high, Gemini 2.5 Pro 06-05, o3 high, DeepSeek-R1-0528 e variantes Qwen3. Isso não significa automaticamente que esses sejam os melhores assistentes de codificação de produção. Isso significa que eles são fortes na geração de estilo de programação competitiva nessa janela publicada.
Use o LiveCodeBench quando sua pergunta for "qual modelo resolve problemas de codificação algorítmica?" Use SWE-bench ou Aider quando sua pergunta for "qual modelo pode alterar minha base de código corretamente?"
Pontuações de raciocínio matemático e científico
O raciocínio matemático e científico são agora uma comparação separada da codificação geral.
Os dados de lançamento do GPT-5.5 relatam 51,7% no FrontierMath Tier 1-3 e 35,4% no FrontierMath Tier 4, juntamente com 58,6% no SWE-Bench Pro. Esses números apontam para um modelo otimizado para trabalho científico e de agência árduo e de várias etapas, em vez de apenas instruções de codificação curtas.
Relatório técnico e relatório de cartão de modelo do DeepSeek V3.2 82,4% no GPQA Diamond e 85,0% no MMLU-Pro. O mesmo modelo de evidência de cartão lista 70,0% resolvidos no SWE-bench Verified, enquanto o relatório técnico usa uma estrutura de agente de código interno separada para seu maior resultado interno SWE-Verified. Isso torna o DeepSeek muito mais difícil de descartar como uma opção apenas orçamentária, mas as duas configurações de avaliação não devem ser mescladas. A implantação, a latência, o uso de ferramentas e a política de dados ainda são importantes.
O Gemini 3.1 Pro deve ser lido como um modelo de raciocínio multimodal nativo da última geração Gemini 3 do Google. Se o seu fluxo de trabalho matemático incluir diagramas, contexto visual, documentos longos ou entradas multimodais, as comparações do placar somente com texto bruto perderão parte da imagem. O artigo prático aqui é Gemini Deep Thinking API: Build Math AI Apps.
Pontuações de fluxo de trabalho de agente e terminal
A codificação Agentic não é o mesmo que o preenchimento automático.
As avaliações do Terminal-Bench, SWE-Bench Pro e do agente de codificação real perguntam se um modelo pode acompanhar uma tarefa, usar ferramentas, inspecionar resultados, recuperar-se de erros e concluir trabalhos úteis. O número 82,7% Terminal-Bench 2.0 do GPT-5.5 é um forte sinal para esta categoria.
Claude Opus 5 também é relevante aqui porque a página de modelo ao vivo do Anthropic agora o lista acima das entradas mais antigas do Opus. A página deve ser tratada como uma referência de produto atual e não como um substituto para uma linha de referência comparável de terceiros.
É também aqui que a escolha da ferramenta é importante. Cursor, código Claude, agentes de terminal estilo Codex e scaffolds personalizados podem alterar o resultado. A questão relacionada não é apenas “qual modelo?” mas "qual modelo dentro de qual fluxo de trabalho?" Para saber a armadilha de produtividade por trás disso, leia Ferramentas de codificação de IA: 19% mais lentas apesar de parecerem mais rápidas.
O que mudou desde fevereiro de 2026
A versão de fevereiro deste artigo tratou Claude Opus 4.5, GPT-5.2, Gemini 2.5 Pro e DeepSeek V3.1 como o conjunto central de comparação. Isso não é mais recente o suficiente para uma página de benchmark de 2026.
Aqui está a atualização de junho de 2026:
| Enquadramento de fevereiro | Atualização de junho de 2026 |
|---|---|
| Claude Opus 4.5 como líder de codificação premium | Claude Opus 5 está agora listado como o atual modelo de fronteira antrópica para codificação e agentes |
| GPT-5.2 como principal modelo de raciocínio OpenAI | GPT-5.5 agora ancora a comparação OpenAI para benchmarks de raciocínio científico e terminal |
| Gemini 2.5 Pro como história da janela de contexto | Gemini 3.1 Pro é o atual alvo do cartão modelo do Google; verifique a reivindicação de contexto ao vivo da Antrópica separadamente |
| DeepSeek V3.1 como concorrente de valor | DeepSeek V3.2 e V3.2-Speciale são agora as referências relevantes de raciocínio/codificação |
| Uma afirmação de "melhor modelo" | Comparação específica de tarefas entre SWE-bench, Aider, LiveCodeBench, Terminal-Bench e raciocínio matemático |
A história do modelo aberto também mudou. As entradas Kimi K2.5, Qwen, GLM, MiniMax e DeepSeek agora aparecem com frequência suficiente em tabelas de classificação públicas para que devam ser tratadas como opções reais, não como curiosidades. O ângulo Moonshot é abordado separadamente em Verbose AI Beats Fast AI: Moonshot K2 $ 1.172 Paradox.
Qual modelo você deve usar?
| Caso de uso | Melhor ponto de partida | Por que |
|---|---|---|
| Correção de bug de repositório real | Sistemas da família Claude ou Gemini/GPT com fortes resultados de andaime de bancada SWE | SWE-bench recompensa compreensão de repositório, testes e validação de patch |
| Edição IDE com muitos patches | GPT-5 alto/médio em fluxos de trabalho estilo Aider | Aider enfatiza diferenças limpas e edição multilíngue |
| Trabalho autônomo com muitos terminais | Configurações de agente estilo GPT-5.5 ou Claude Opus 5 | Terminal-Bench e posicionamento de lançamento de agente são mais importantes do que preenchimento automático |
| Raciocínio matemático e científico | GPT-5.5, DeepSeek V3.2-Speciale, Gemini 3.1 Pro | Use FrontierMath, GPQA, MMLU-Pro e contexto de raciocínio multimodal juntos |
| Codificação sensível ao orçamento | Opções da família DeepSeek V3.2, Kimi K2.5, Qwen/GLM | As pontuações públicas agora são fortes o suficiente para justificar pilotos sérios |
| Trabalho profissional de grande contexto | Claude Opus 5 ou Gemini 3.1 Pro | A janela de contexto e o manuseio multimodal/de documentos podem dominar as pontuações de codificação bruta |
Para a maioria das equipes, a melhor pilha é a híbrida:
- Use um modelo rápido e mais barato para edições e explicações de rotina.
- Use um modelo de raciocínio mais forte para bugs graves, arquitetura e execuções de agentes em várias etapas.
- Valide cada saída do modelo com testes, revisão e observabilidade.
- Verifique novamente os dados de referência mensalmente, pois o placar público pode mudar mais rapidamente do que o seu ciclo de compras.
Advertências de referência
Metodologia e níveis de origem
Cada pontuação nesta página é marcada por classe de origem: dados de lançamento relatados pelo fornecedor, dados de tabelas de classificação de terceiros ou um instantâneo de benchmark público. Os resultados do fornecedor são úteis para compreender a configuração escolhida pelo fabricante; resultados de terceiros são mais úteis para contextos de modelos cruzados; nem é garantia de desempenho em seu repositório.
Para cada linha, a revisão registra a versão do modelo, a data do conjunto de dados ou do placar, a estrutura, o acesso à ferramenta, a métrica de sucesso e se o resultado pode ser reproduzido. O guia de metodologia de benchmark de IA contém o modelo completo de registro de evidências e regras de atualização. Quando uma fonte não publica um número comparável, a tabela utiliza intencionalmente um rótulo qualitativo em vez de inventar uma pontuação.
As pontuações de benchmark são úteis, mas não são guias do comprador por si só.
O andaime altera a pontuação. As entradas do SWE-bench geralmente incluem um modelo mais um sistema de agente. Recuperação, seleção de arquivos, execução de ferramentas, novas tentativas e equipamentos de teste podem alterar drasticamente o resultado.
Aider, SWE-bench e LiveCodeBench medem trabalhos diferentes. Um modelo pode ser excelente em edições de código e mais fraco em reparos de bugs de repositórios reais. Outro pode resolver concursos de algoritmos, mas tem dificuldades com códigos de produção confusos.
As pontuações de lançamento do fornecedor e os placares públicos não devem ser mesclados cegamente. Mantenha-os em linhas separadas, a menos que a tarefa, o conjunto de dados e o equipamento de avaliação sejam idênticos.
Latência e custo são invisíveis em muitos resumos. Um modelo que obtém uma pontuação mais alta com raciocínio pesado pode ser a escolha errada para uso de IDE em tempo real.
A atualização é importante. Um artigo de referência de 2026 deve indicar a data de verificação dos dados. Se esta página tiver mais de um mês quando você a ler, verifique a tabela de classificação mais recente antes de tomar uma decisão séria sobre o modelo.
Conclusão
A melhor comparação de benchmark 2026 LLM não é “Claude vs GPT vs Gemini vs DeepSeek” como uma única luta. É um mapa:
- GPT-5.5 parece mais forte nos dados de lançamento da OpenAI de junho de 2026 para tarefas de agente terminal e raciocínio científico.
- Claude Opus 5 é o mais novo modelo Anthropic listado para codificação, agentes e trabalho profissional; verifique os detalhes da avaliação ao vivo antes de compará-la numericamente.
- Gemini 3.1 Pro é o atual modelo de cartão-modelo de raciocínio multimodal do Google.
- DeepSeek V3.2 é o concorrente de valor que agora merece pilotos sérios de codificação e raciocínio.
- Aider, SWE-bench, LiveCodeBench e Terminal-Bench respondem a perguntas diferentes, portanto, use o benchmark que corresponda ao seu fluxo de trabalho.
Se você se lembra apenas de uma regra: escolha o benchmark que se parece com sua tarefa real e, em seguida, escolha o modelo.