Mise à jour éditoriale : 21 août 2026. Les instantanés de référence numériques ont été examinés pour la dernière fois le 8 juin 2026 ; l'accessibilité de la source, la fraîcheur des pages de modèles et le rapport technique DeepSeek ont été revérifiés le 21 août. Vérifiez les classements en direct avant de prendre une décision d'achat ou de migration.
Si vous avez recherché Comparaison du raisonnement mathématique des scores de référence LLM 2026, la version courte est la suivante : faites correspondre le test de référence à la tâche avant de choisir un modèle, puis vérifiez la date source, l'échafaudage et la mesure de réussite.
Les corrections de bogues de codage, les concours d'algorithmes, le raisonnement mathématique et les flux de travail des agents de terminal ne sont plus mesurés par le même tableau de bord. GPT-5.5, Claude Opus 5, Gemini 3.1 Pro et DeepSeek V3.2 apparaissent tous dans des contextes sources différents. La démarche utile consiste à comparer la bonne référence pour le travail.
Quelle référence LLM devriez-vous utiliser ?
Utilisez SWE-bench pour une véritable réparation de référentiel, Aider Polyglot pour la qualité de l'édition de code, LiveCodeBench pour le codage algorithmique et Terminal-Bench pour le travail d'agent gourmand en shell. Aucun benchmark ne prouve à lui seul qu'un modèle convient le mieux à chaque flux de travail de développement. Choisissez donc le test qui correspond le plus à la tâche que votre équipe exécutera réellement.
| Si vous devez évaluer | Commencez par | Vérifiez ensuite |
|---|---|---|
| Corrections de bogues et correctifs de dépôt | Banc SWE Vérifié | Autorisations d'échafaudage, de stratégie de test et d'outil |
| Édition multi-fichiers dans un IDE | Aide polyglotte | Coût, différence de qualité et charge de révision |
| Algorithmes et nouveaux problèmes de codage | LiveCodeBench | Contrôles de contamination et difficulté des tâches |
| Travail de terminal autonome | Banc de terminal | Bac à sable, tentatives et portes d'approbation humaine |
Benchmarks de codage LLM 2026 : carte rapide
L'expression repères de codage LLM couvre plusieurs tests différents. SWE-bench mesure la correction de bogues réels dans les dépôts, Aider mesure la qualité d'édition multilingue, LiveCodeBench mesure les performances des défis de programmation et Terminal-Bench mesure l'exécution des agents de ligne de commande.
C'est pourquoi une comparaison utile du LLM coding benchmark 2026 ne devrait pas tout regrouper en un seul score. Faites d'abord correspondre le benchmark à votre flux de travail, puis comparez les résultats GPT, Claude, Gemini, DeepSeek et le modèle ouvert dans ce contexte.
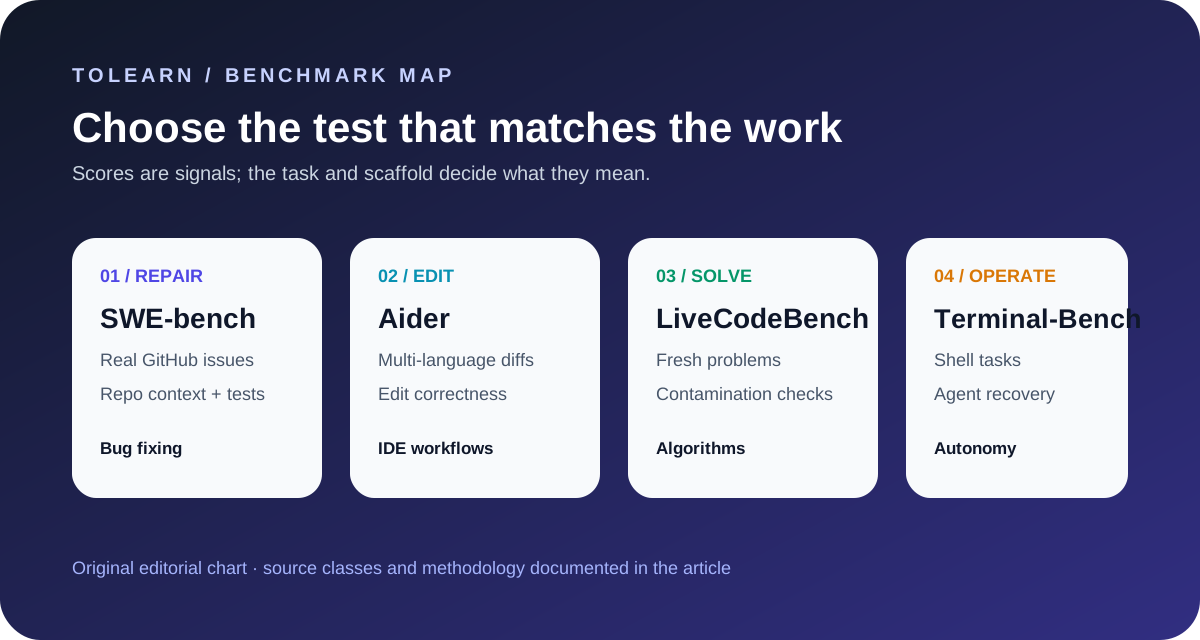
Graphique original : mappage éditorial de ToLearn des familles de référence avec les flux de travail qu'elles mesurent réellement.
Scores de référence actuels du LLM 2026
Cet instantané sépare les classements publics des métriques de version signalées par les fournisseurs. Cette distinction est importante : un modèle brut, un agent de codage et un assistant IDE peuvent afficher des scores très différents même lorsqu'ils utilisent le même modèle sous-jacent.
| Entrée de modèle ou de classement | Score de codage | Score de mathématiques/raisonnement | Meilleure lecture | Source | Type de source |
|---|---|---|---|---|---|
| GPT-5.5 | SWE-Bench Pro : 58,6 % ; Terminal-Bench 2.0 : 82,7 % | FrontierMath niveaux 1-3 : 51,7 % ; Niveau 4 : 35,4 % | Signal le plus fort en faveur des workflows de terminaux agents et d'un raisonnement scientifique rigoureux dans les données de publication d'OpenAI | OpenAI GPT-5.5 | Rapport du fournisseur |
| Claude Opus 5 | Dernier modèle de codage des frontières anthropiques et d'agent ; aucun score public comparable enregistré dans cet instantané | Vérifier le contexte actuel et les détails de l'évaluation sur la page du modèle dynamique | Référence actuelle de la page du modèle Anthropic ; ne traitez pas la page de modèle qualitatif comme un score de référence multi-fournisseurs | Anthropique Claude Opus | Page fournisseur/modèle |
| Gémeaux 3.1 Pro | Dernière carte modèle de la série Gemini 3 | Modèle de raisonnement multimodal natif | Mieux évalué en tant que modèle de raisonnement multimodal et de contexte long ; utiliser les classements de codage publics lorsque les scores exacts des tâches sont importants | Google DeepMind Gemini 3.1 Pro | Fiche du fournisseur/modèle |
| DeepSeek V3.2 | SWE-bench Vérifié : Résolu à 70,0 % | Diamant GPQA : 82,4 % ; MMLU-Pro : 85,0 % | Forte capacité de raisonnement et de codage axé sur la valeur, en particulier lorsque le coût compte | Carte modèle DeepSeek V3.2 | Carte modèle |
| Classement des Aider Polyglot | GPT-5 élevé : 88,0 % ; Milieu GPT-5 : 86,7 % ; Gémeaux 2.5 Pro : 83,1 % ; Raisonneur DeepSeek V3.2 : 74,2 % | Pas une référence mathématique | Idéal pour l'édition de code du monde réel et la qualité des différences | Classement des aides | Tierce personne |
| Instantané public du SWE-bench | Rapports vérifiés % résolus sur 500 tâches | Pas une référence mathématique | Idéal pour la réparation réelle des problèmes GitHub ; Les principales entrées publiques actuelles incluent les variantes Claude-family, Gemini 3, GPT-5.2 Codex, Kimi K2.5 et DeepSeek V3.2. | SWE-banc | Tierce personne |
Le titre : GPT-5.5 est l'histoire de données de lancement la plus solide pour le raisonnement terminal et scientifique ; Claude Opus 5 est le dernier modèle Anthropic répertorié pour le codage agent ; Gemini 3.1 Pro est le dernier modèle de raisonnement multimodal de Google ; DeepSeek V3.2 est le modèle de valeur à surveiller. Pour un chemin d'archivage plus large, consultez le hub thématique AI Model Comparisons et notre Comparaison des outils d'agent IA pour les choix au niveau du flux de travail.
Codage des scores de référence
Les repères de codage divisés en trois familles utiles :
| Référence | Ce qu'il teste | Meilleure utilisation |
|---|---|---|
| ** Banc SWE vérifié ** | Problèmes réels avec GitHub, compréhension des dépôts, correctifs, tests | Agents de correction de bogues et de codage de style production |
| Aider Polyglotte | Édition de code multilingue et correction des différences | Flux de travail IDE et correctifs |
| LiveCodeBench | Problèmes de programmation compétitifs continuellement actualisés | Codage algorithmique et résolution de problèmes résistant à la contamination |
| Banc de terminaux | Tâches de ligne de commande et exécution d'agent | Flux de travail autonomes gourmands en coque |
SWE-bench : réparation d'un véritable référentiel
SWE-bench reste la référence publique la plus importante en matière de capacité réelle de correction de bogues, car elle évalue si un système peut résoudre les problèmes réels du référentiel. Le classement public indique % de résolution, et non un score générique de « QI de codage ».
Cette distinction est importante. Une entrée élevée dans le SWE-bench reflète souvent à la fois le modèle et l'échafaudage qui l'entoure : récupération, édition de fichiers, appels d'outils, exécution de tests, politique de nouvelle tentative et validation des correctifs. C'est pourquoi les modèles de la famille Claude, les entrées Gemini 3, les entrées du Codex GPT-5.2, Kimi K2.5 et les variantes DeepSeek peuvent tous apparaître dans le même écosystème public sans produire un simple classement réservé aux modèles.
Si votre flux de travail est sur le point de « corriger ce vrai bug dans ce dépôt », SWE-bench est le bon point de départ. Si votre flux de travail consiste à « modifier proprement ce fichier dans mon IDE », Aider est souvent plus utile.
Aider Polyglot : qualité d'édition
Le Classement Aider est particulièrement utile car il teste si un modèle peut produire des modifications utilisables dans tous les langages de programmation. Depuis cette actualisation, les lignes notables sont :
| Modèle | Pourcentage correct | Coût dans l'exécution d'Aider | Ce que cela suggère |
|---|---|---|---|
| GPT-5 élevé | 88.0% | $29.08 | Meilleur signal pour des modifications de haute précision dans ce classement |
| Moyen GPT-5 | 86.7% | $17.69 | Presque aussi puissant à moindre coût |
| Gemini 2.5 Pro Aperçu 05-06 | 83.1% | Varie | Base d'édition solide de la génération précédente de Google |
| Raisonneur DeepSeek V3.2 | 74.2% | $1.30 | Fort profil rapport qualité-prix |
C'est pourquoi je ne lirais pas le « meilleur modèle de codage » comme une affirmation universelle. Si vous effectuez un travail nécessitant beaucoup de correctifs, les résultats d'Aider de type GPT-5 sont importants. Si vous effectuez une réparation de pension autonome, SWE-bench et votre échafaudage d'agent sont plus importants.
Pour les tactiques pratiques de flux de travail OpenAI, l'élément complémentaire plus ancien mais toujours utile est GPT-5 for Coding: Benchmarks, Pricing & 5 Pro Tips.
LiveCodeBench : algorithmes et résistance à la contamination
LiveCodeBench est précieux car il ajoute continuellement des problèmes de programmation, ce qui réduit le risque de contamination des ensembles de formation par rapport aux benchmarks statiques.
Dans la fenêtre publique actuellement sélectionnée (du 1er août 2024 au 1er mai 2025), les entrées fortes incluent les variantes o4-mini high, Gemini 2.5 Pro 06-05, o3 high, DeepSeek-R1-0528 et Qwen3. Cela ne signifie pas automatiquement que ce sont les meilleurs assistants de codage de production. Cela signifie qu'ils sont forts dans la génération de programmation de type compétitif dans cette fenêtre de publication.
Utilisez LiveCodeBench lorsque votre question est « quel modèle résout les problèmes de codage algorithmique ? » Utilisez SWE-bench ou Aider lorsque votre question est « quel modèle peut modifier correctement ma base de code ? »
Scores de raisonnement mathématique et scientifique
Les mathématiques et le raisonnement scientifique constituent désormais une comparaison distincte du codage général.
Les données de publication de GPT-5.5 rapportent 51,7 % sur FrontierMath Tier 1-3 et 35,4 % sur FrontierMath Tier 4, ainsi que 58,6 % sur SWE-Bench Pro. Ces chiffres indiquent un modèle optimisé pour un travail scientifique et agent dur et en plusieurs étapes plutôt que pour des invites de codage abrégées.
Rapport technique et rapport de carte modèle de DeepSeek V3.2 82,4 % sur GPQA Diamond et 85,0 % sur MMLU-Pro. La même preuve de carte modèle répertorie 70,0 % résolus sur SWE-bench Verified, tandis que le rapport technique utilise un cadre d'agent de code interne distinct pour son résultat interne SWE-Verified plus élevé. Cela rend DeepSeek beaucoup plus difficile à rejeter en tant qu'option uniquement budgétaire, mais les deux configurations d'évaluation ne doivent pas être fusionnées. Le déploiement, la latence, l'utilisation des outils et la politique en matière de données restent importants.
Gemini 3.1 Pro doit être lu comme un modèle de raisonnement multimodal natif de la dernière génération Gemini 3 de Google. Si votre flux de travail mathématique comprend des diagrammes, un contexte visuel, des documents longs ou des entrées multimodales, les comparaisons de classement en texte brut uniquement manqueront une partie de l'image. L'article complémentaire pratique ici est API Gemini Deep Thinking : Build Math AI Apps.
Scores de flux de travail agent et terminal
Le codage agent n’est pas la même chose que la saisie semi-automatique.
Les évaluations de Terminal-Bench, SWE-Bench Pro et de véritables agents de codage demandent si un modèle peut suivre une tâche, utiliser des outils, inspecter les sorties, récupérer des erreurs et terminer un travail utile. Le chiffre 82,7 % Terminal-Bench 2.0 de GPT-5.5 est un signal fort pour cette catégorie.
Claude Opus 5 est également pertinent ici car la page de modèles vivants d'Anthropic le répertorie désormais au-dessus des anciennes entrées Opus. La page doit être traitée comme une référence de produit actuelle, et non comme un substitut à une ligne de référence tierce comparable.
C'est également là que le choix des outils est important. Le curseur, le code Claude, les agents terminaux de style Codex et les échafaudages personnalisés peuvent modifier le résultat. La question connexe n’est pas seulement « quel modèle ? mais "quel modèle dans quel workflow ?" Pour connaître le piège de la productivité derrière cela, lisez AI Coding Tools : 19 % plus lent malgré le sentiment de rapidité.
Ce qui a changé depuis février 2026
La version de février de cet article traitait Claude Opus 4.5, GPT-5.2, Gemini 2.5 Pro et DeepSeek V3.1 comme ensemble de comparaison central. Ce n’est plus assez récent pour une page de référence 2026.
Voici la mise à jour de juin 2026 :
| Encadrement de février | Actualisation de juin 2026 |
|---|---|
| Claude Opus 4.5 comme leader du codage premium | Claude Opus 5 est désormais répertorié comme le modèle de frontière anthropique actuel pour le codage et les agents |
| GPT-5.2 comme principal modèle de raisonnement OpenAI | GPT-5.5 ancre désormais la comparaison OpenAI pour les références de terminal et de raisonnement scientifique |
| Gemini 2.5 Pro comme histoire de fenêtre contextuelle | Gemini 3.1 Pro est la cible actuelle de la carte modèle de Google ; vérifier séparément la revendication de contexte en direct d'Anthropic |
| DeepSeek V3.1 comme concurrent de valeur | DeepSeek V3.2 et V3.2-Speciale sont désormais les références de raisonnement/codage pertinentes |
| Une affirmation du « meilleur modèle » | Comparaison spécifique à une tâche entre SWE-bench, Aider, LiveCodeBench, Terminal-Bench et le raisonnement mathématique |
L’histoire du modèle ouvert a également changé. Les entrées Kimi K2.5, Qwen, GLM, MiniMax et DeepSeek apparaissent désormais assez souvent dans les classements publics pour qu'elles doivent être traitées comme de véritables options et non comme des curiosités. L'angle Moonshot est traité séparément dans Verbose AI Beats Fast AI: Moonshot K2 $1,172 Paradox.
Quel modèle devriez-vous utiliser ?
| Cas d'utilisation | Meilleur point de départ | Pourquoi |
|---|---|---|
| Correction d'un bug de dépôt réel | Systèmes de la famille Claude ou Gemini/GPT avec de solides résultats d'échafaudage SWE-bench | Le SWE-bench récompense la compréhension des dépôts, les tests et la validation des correctifs |
| Édition IDE lourde de correctifs | GPT-5 élevé/moyen dans les flux de travail de type Aider | Aider met l'accent sur les différences nettes et l'édition multilingue |
| Travail autonome lourd en terminal | Configurations d'agents de style GPT-5.5 ou Claude Opus 5 | Le positionnement de Terminal-Bench et du lancement agent compte plus que la saisie semi-automatique |
| Mathématiques et raisonnement scientifique | GPT-5.5, DeepSeek V3.2-Spécial, Gemini 3.1 Pro | Utilisez ensemble FrontierMath, GPQA, MMLU-Pro et le contexte de raisonnement multimodal |
| Codage sensible au budget | DeepSeek V3.2, Kimi K2.5, options de la famille Qwen/GLM | Les scores publics sont désormais suffisamment élevés pour justifier des pilotes sérieux |
| Travail professionnel dans un grand contexte | Claude Opus 5 ou Gemini 3.1 Pro | La fenêtre contextuelle et la gestion multimodale/document peuvent dominer les scores de codage bruts |
Pour la plupart des équipes, la meilleure pile est hybride :
- Utilisez un modèle rapide et moins cher pour les modifications et explications de routine.
- Utilisez un modèle de raisonnement plus solide pour les bugs majeurs, l'architecture et les exécutions d'agents en plusieurs étapes.
- Validez chaque sortie du modèle avec des tests, des examens et de l'observabilité.
- Vérifiez à nouveau les données de référence chaque mois, car le classement public peut changer plus rapidement que votre cycle d'approvisionnement.
Mises en garde concernant les références
Méthodologie et niveaux de source
Chaque score sur cette page est étiqueté par classe source : données de version signalées par le fournisseur, données de classement tiers ou instantané de référence public. Les résultats des fournisseurs sont utiles pour comprendre la configuration choisie par le fabricant ; les résultats tiers sont plus utiles dans un contexte inter-modèles ; ce n’est pas non plus une garantie de performances dans votre référentiel.
Pour chaque ligne, l'examen enregistre la version du modèle, la date de l'ensemble de données ou du classement, l'échafaudage, l'accès à l'outil, la mesure de réussite et si le résultat peut être reproduit. Le Guide méthodologique de référence de l'IA contient le modèle complet de registre de preuves et les règles d'actualisation. Lorsqu’une source ne publie pas un chiffre comparable, le tableau utilise intentionnellement une étiquette qualitative au lieu d’inventer une partition.
Les scores de référence sont utiles, mais ils ne constituent pas en eux-mêmes des guides d’achat.
L'échafaudage change le score. Les entrées du SWE-bench incluent souvent un modèle plus un système d'agent. La récupération, la sélection de fichiers, l'exécution d'outils, les nouvelles tentatives et les tests peuvent modifier considérablement le résultat.
Aider, SWE-bench et LiveCodeBench mesurent différents travaux. Un modèle peut être excellent pour l'édition de code et plus faible pour la réparation de bugs de dépôt réels. Un autre peut résoudre des concours d’algorithmes mais a du mal à gérer un code de production désordonné.
Les scores de lancement des fournisseurs et les classements publics ne doivent pas être fusionnés aveuglément. Conservez-les dans des lignes séparées à moins que la tâche, l'ensemble de données et le faisceau d'évaluation ne soient identiques.
La latence et le coût sont invisibles dans de nombreux résumés. Un modèle qui obtient un score plus élevé avec un raisonnement approfondi peut être un mauvais choix pour une utilisation de l'IDE en temps réel.
La fraîcheur compte. Un article de référence de 2026 devrait nommer la date de vérification des données. Si cette page date de plus d'un mois lorsque vous la lisez, vérifiez le dernier classement avant de prendre une décision sérieuse en matière de modèle.
Conclusion
La meilleure comparaison de référence LLM 2026 n'est pas "Claude vs GPT vs Gemini vs DeepSeek" en tant que combat unique. C'est une carte :
- GPT-5.5 semble le plus puissant dans les données de lancement d'OpenAI de juin 2026 pour les tâches d'agent terminal et de raisonnement scientifique.
- Claude Opus 5 est le dernier modèle Anthropic répertorié pour le codage, les agents et le travail professionnel ; vérifiez les détails de son évaluation en direct avant de la comparer numériquement.
- Gemini 3.1 Pro est la cible actuelle de la carte modèle de raisonnement multimodal de Google.
- DeepSeek V3.2 est le concurrent de valeur qui mérite désormais de sérieux projets pilotes de codage et de raisonnement.
- Aider, SWE-bench, LiveCodeBench et Terminal-Bench répondent à différentes questions, utilisez donc le benchmark qui correspond à votre flux de travail.
Si vous ne vous souvenez que d'une seule règle : choisissez le benchmark qui ressemble à votre tâche réelle, puis choisissez le modèle.