Redaktionelle Aktualisierung: 21. August 2026. Numerische Benchmark-Schnappschüsse wurden zuletzt am 8. Juni 2026 überprüft; Die Erreichbarkeit der Quelle, die Aktualität der Modellseite und der technische Bericht von DeepSeek wurden am 21. August erneut überprüft. Überprüfen Sie die Live-Bestenlisten, bevor Sie eine Kauf- oder Migrationsentscheidung treffen.
Wenn Sie nach LLM Benchmark Scores 2026 Coding Math Reasoning Vergleich gesucht haben, lautet die Kurzversion: Passen Sie den Benchmark an die Aufgabe an, bevor Sie ein Modell auswählen, und überprüfen Sie dann das Quelldatum, das Gerüst und die Erfolgsmetrik.
Codierungsfehlerkorrekturen, Algorithmuswettbewerbe, mathematisches Denken und Terminal-Agent-Workflows werden nicht mehr anhand derselben Anzeigetafel gemessen. GPT-5.5, Claude Opus 5, Gemini 3.1 Pro und DeepSeek V3.2 erscheinen alle in unterschiedlichen Quellkontexten. Der sinnvolle Schritt besteht darin, den richtigen Maßstab für den Job zu vergleichen.
Welchen LLM-Benchmark sollten Sie verwenden?
Verwenden Sie SWE-Bench für echte Repository-Reparaturen, Aider Polyglot für Codebearbeitungsqualität, LiveCodeBench für algorithmische Codierung und Terminal-Bench für Shell-lastige Agentenarbeit. Kein einzelner Benchmark beweist, dass ein Modell für jeden Entwicklungsworkflow am besten geeignet ist. Wählen Sie daher den Test aus, der der Aufgabe, die Ihr Team tatsächlich ausführen wird, am ehesten entspricht.
| Wenn Sie eine Bewertung benötigen | Beginnen Sie mit | Dann überprüfen |
|---|---|---|
| Repo-Fehlerbehebungen und -Patches | SWE-Bench verifiziert | Gerüst, Testrichtlinie und Toolberechtigungen |
| Bearbeitung mehrerer Dateien in einer IDE | Helfer Polyglott | Kosten, Differenzqualität und Überprüfungsaufwand |
| Algorithmen und neue Codierungsprobleme | LiveCodeBench | Kontaminationskontrollen und Aufgabenschwierigkeiten |
| Autonome Terminalarbeit | Terminal-Bench | Sandbox, Wiederholungsversuche und menschliche Genehmigungstore |
LLM-Coding-Benchmarks 2026: Kurzübersicht
Der Begriff LLM-Coding-Benchmarks umfasst mehrere verschiedene Tests. SWE-Bench misst echte Repo-Fehlerbehebung, Aider misst die Bearbeitungsqualität in mehreren Sprachen, LiveCodeBench misst die Leistung bei Programmierherausforderungen und Terminal-Bench misst die Ausführung von Befehlszeilenagenten.
Aus diesem Grund sollte ein nützlicher Vergleich des LLM Coding Benchmark 2026 nicht alles in einem Ergebnis zusammenfassen. Passen Sie zunächst den Benchmark an Ihren Workflow an und vergleichen Sie dann die Ergebnisse von GPT, Claude, Gemini, DeepSeek und offenen Modellen in diesem Kontext.
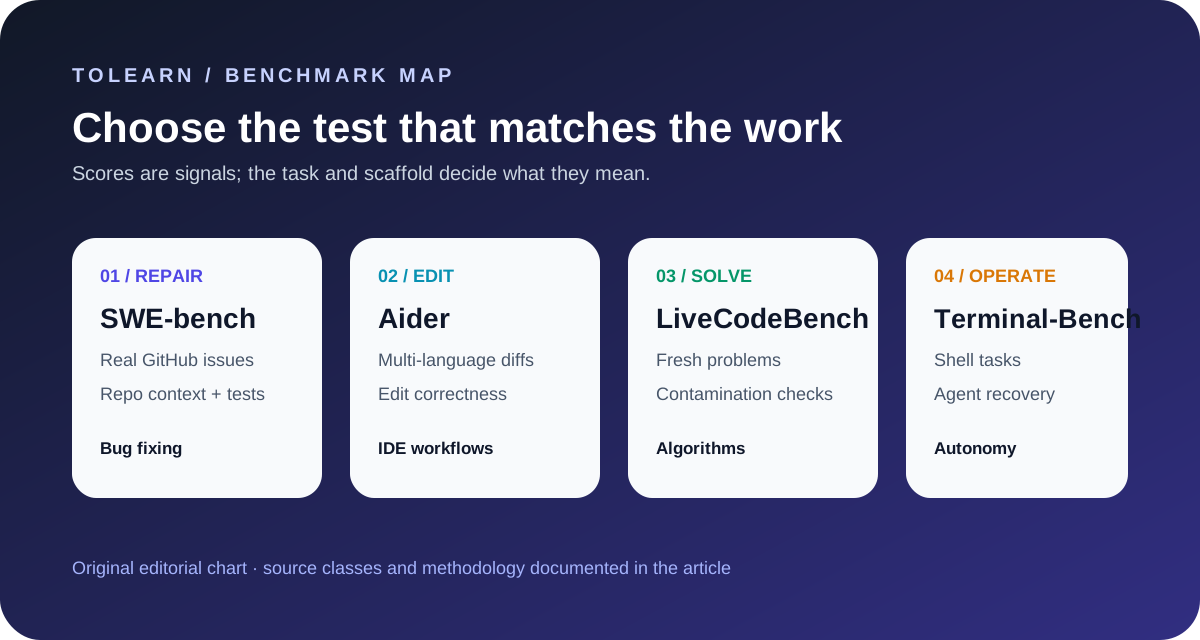
Originaldiagramm: ToLearns redaktionelle Zuordnung der Benchmark-Familien zu den Arbeitsabläufen, die sie tatsächlich messen.
Aktuelle LLM-Benchmark-Ergebnisse 2026
Dieser Schnappschuss trennt öffentliche Bestenlisten von vom Anbieter gemeldeten Release-Metriken. Diese Unterscheidung ist wichtig: Ein Rohmodell, ein Coding-Agent und ein IDE-Assistent können sehr unterschiedliche Ergebnisse erzielen, selbst wenn sie dasselbe zugrunde liegende Modell verwenden.
| Modell- oder Bestenlisteneintrag | Codierungspunktzahl | Mathe-/Argumentationsergebnis | Beste Anzeige | Quelle | Quelltyp |
|---|---|---|---|---|---|
| GPT-5.5 | SWE-Bench Pro: 58,6 %; Terminal-Bench 2.0: 82,7 % | FrontierMath Tier 1–3: 51,7 %; Stufe 4: 35,4 % | Stärkstes Signal für Agenten-Terminal-Workflows und fundierte wissenschaftliche Begründung in den Veröffentlichungsdaten von OpenAI | OpenAI GPT-5.5 | Lieferantenbericht |
| Claude Opus 5 | Neuestes Anthropic Frontier Codierungs- und Agentenmodell; In diesem Schnappschuss ist kein vergleichbarer öffentlicher Score verzeichnet | Überprüfen Sie den aktuellen Kontext und die Bewertungsdetails auf der Live-Modellseite | Referenz zur aktuellen Anthropic-Modellseite; Behandeln Sie die qualitative Modellseite nicht als anbieterübergreifenden Benchmark-Score | Anthropic Claude Opus | Anbieter-/Modellseite |
| Gemini 3.1 Pro | Neueste Modellkarte der Gemini 3-Serie | Natives multimodales Argumentationsmodell | Am besten als multimodales Argumentations- und Langkontextmodell bewertet; Verwenden Sie öffentliche Coding-Bestenlisten, wenn genaue Aufgabenergebnisse wichtig sind | Google DeepMind Gemini 3.1 Pro | Anbieter-/Modellkarte |
| DeepSeek V3.2 | SWE-Bench bestätigt: 70,0 % gelöst | GPQA-Diamant: 82,4 %; MMLU-Pro: 85,0 % | Starker Kandidat für wertorientiertes Denken und Kodieren, insbesondere wenn es um Kosten geht | DeepSeek V3.2-Modellkarte | Modellkarte |
| Aider Polyglot-Rangliste | GPT-5 hoch: 88,0 %; GPT-5-Medium: 86,7 %; Gemini 2.5 Pro: 83,1 %; DeepSeek V3.2 Reasoner: 74,2 % | Kein mathematischer Benchmark | Am besten für die Bearbeitung von Code in der realen Welt und für die Diff-Qualität geeignet | Aider-Rangliste | Drittanbieter |
| Öffentlicher Schnappschuss der SWE-bench | Verifizierte Berichte % gelöst über 500 Aufgaben | Kein mathematischer Benchmark | Am besten für die Reparatur echter GitHub-Probleme geeignet; Zu den aktuellen Top-öffentlichen Einträgen gehören die Varianten Claude-family, Gemini 3, GPT-5.2 Codex, Kimi K2.5 und DeepSeek V3.2 | SWE-bench | Drittanbieter |
Die Schlagzeile: GPT-5.5 ist die stärkste Startdatengeschichte für terminale und wissenschaftliche Überlegungen; Claude Opus 5 ist die neueste Anthropic-Version, die für die Agentencodierung aufgeführt ist. Gemini 3.1 Pro ist das neueste multimodale Argumentationsmodell von Google. DeepSeek V3.2 ist das Wertmodell, das Sie im Auge behalten sollten. Einen breiteren Archivpfad finden Sie im Themen-Hub „KI-Modellvergleiche“ und in unserem Vergleich der KI-Agent-Tools für Auswahlmöglichkeiten auf Workflow-Ebene.
Codierungs-Benchmark-Ergebnisse
Codierungs-Benchmarks sind in drei nützliche Familien unterteilt:
| Benchmark | Was es testet | Beste Verwendung |
|---|---|---|
| SWE-Bench verifiziert | Echte GitHub-Probleme, Repo-Verständnis, Patches, Tests | Fehlerbehebung und Codierungsagenten im Produktionsstil |
| Helfer Polyglott | Mehrsprachige Codebearbeitung und Diff-Korrektheit | IDE- und Patch-Workflows |
| LiveCodeBench | Kontinuierlich aktualisierte wettbewerbsfähige Programmierprobleme | Algorithmische Kodierung und kontaminationsresistente Problemlösung |
| Terminal-Bench | Befehlszeilenaufgaben und Agentenausführung | Shell-lastige autonome Arbeitsabläufe |
SWE-Benchmark: Real Repository Repair
SWE-bench bleibt der wichtigste öffentliche Maßstab für echte Fehlerbehebungsfähigkeiten, da er bewertet, ob ein System tatsächliche Repository-Probleme lösen kann. Die öffentliche Bestenliste gibt % gelöst an, keinen allgemeinen „Codierungs-IQ“-Wert.
Diese Unterscheidung ist wichtig. Ein hoher SWE-Bench-Eintrag spiegelt häufig sowohl das Modell als auch das umliegende Gerüst wider: Abruf, Dateibearbeitung, Toolaufrufe, Testausführung, Wiederholungsrichtlinie und Patch-Validierung. Aus diesem Grund können Modelle der Claude-Familie, Gemini 3-Einträge, GPT-5.2 Codex-Einträge, Kimi K2.5 und DeepSeek-Varianten alle im selben öffentlichen Ökosystem erscheinen, ohne dass ein einfaches Ranking nur für Modelle erstellt wird.
Wenn Ihr Workflow kurz davor steht, „diesen echten Fehler in diesem Repo zu beheben“, ist SWE-bench der richtige Ausgangspunkt. Wenn Ihr Arbeitsablauf „Diese Datei sauber in meiner IDE bearbeiten“ lautet, ist Aider oft nützlicher.
Aider Polyglot: Bearbeitungsqualität
Die Aider-Bestenliste ist besonders nützlich, da sie testet, ob ein Modell in allen Programmiersprachen verwendbare Änderungen erzeugen kann. Ab dieser Aktualisierung sind die folgenden bemerkenswerten Zeilen:
| Modell | Prozent richtig | Kosten im Aider-Lauf | Was es vorschlägt |
|---|---|---|---|
| GPT-5 hoch | 88.0% | $29.08 | Bestes Signal für hochpräzise Bearbeitungen in dieser Bestenliste |
| GPT-5-Medium | 86.7% | $17.69 | Fast genauso stark bei geringeren Kosten |
| Gemini 2.5 Pro Vorschau 05-06 | 83.1% | Variiert | Starke Bearbeitungsbasis gegenüber der vorherigen Generation von Google |
| DeepSeek V3.2 Reasoner | 74.2% | $1.30 | Starkes Preis-Leistungs-Verhältnis |
Aus diesem Grund würde ich „bestes Codierungsmodell“ nicht als eine universelle Behauptung verstehen. Wenn Sie patchlastige Arbeiten ausführen, sind die Aider-Ergebnisse im GPT-5-Stil von Bedeutung. Wenn Sie autonome Repo-Reparaturen durchführen, sind die SWE-Bench und Ihr Agentengerüst wichtiger.
Für praktische OpenAI-Workflow-Taktiken ist das ältere, aber immer noch nützliche Begleitstück GPT-5 for Coding: Benchmarks, Pricing & 5 Pro Tips.
LiveCodeBench: Algorithmen und Kontaminationsresistenz
LiveCodeBench ist wertvoll, da es kontinuierlich Programmierprobleme hinzufügt, wodurch das Kontaminationsrisiko des Trainingssatzes im Vergleich zu statischen Benchmarks verringert wird.
Zu den starken Einträgen im aktuell ausgewählten öffentlichen Fenster (1. August 2024 bis 1. Mai 2025) gehören die Varianten o4-mini high, Gemini 2.5 Pro 06-05, o3 high, DeepSeek-R1-0528 und Qwen3. Das bedeutet nicht automatisch, dass dies die besten Produktionscodierungsassistenten sind. Das bedeutet, dass sie in diesem veröffentlichten Fenster stark in der Generierung von kompetitivem Programmierstil sind.
Verwenden Sie LiveCodeBench, wenn Ihre Frage lautet: „Welches Modell löst algorithmische Codierungsprobleme?“ Verwenden Sie SWE-Bench oder Aider, wenn Ihre Frage lautet: „Welches Modell kann meine Codebasis korrekt ändern?“
Ergebnisse für Mathematik und naturwissenschaftliches Denken
Mathematik und wissenschaftliches Denken sind nun ein vom allgemeinen Kodieren getrennter Vergleich.
Die Veröffentlichungsdaten von GPT-5.5 berichten über 51,7 % auf FrontierMath Tier 1-3 und 35,4 % auf FrontierMath Tier 4 sowie 58,6 % auf SWE-Bench Pro. Diese Zahlen deuten auf ein Modell hin, das für harte, mehrstufige wissenschaftliche und agentenbezogene Arbeit optimiert ist und nicht nur für kurze Codierungsaufforderungen.
Technischer Bericht und Modellkartenbericht von DeepSeek V3.2 82,4 % bei GPQA Diamond und 85,0 % bei MMLU-Pro. Derselbe Modellkartenbeweis listet 70,0 % gelöst bei SWE-Bench-Verified auf, während der technische Bericht ein separates internes Code-Agent-Framework für sein höheres internes SWE-Verified-Ergebnis verwendet. Das macht es viel schwieriger, DeepSeek als reine Budgetoption abzutun, aber die beiden Evaluierungs-Setups dürfen nicht zusammengeführt werden. Bereitstellung, Latenz, Tool-Nutzung und Datenrichtlinie sind nach wie vor wichtig.
Gemini 3.1 Pro sollte als natives multimodales Argumentationsmodell aus Googles neuester Gemini 3-Generation gelesen werden. Wenn Ihr Mathematik-Workflow Diagramme, visuellen Kontext, lange Dokumente oder multimodale Eingaben umfasst, wird bei reinen Text-Ranglistenvergleichen ein Teil des Bildes fehlen. Der praktische Begleitartikel hier ist Gemini Deep Thinking API: Build Math AI Apps.
Agenten- und Terminal-Workflow-Scores
Agentencodierung ist nicht dasselbe wie Autovervollständigung.
Bei Terminal-Bench-, SWE-Bench Pro- und echten Coding-Agent-Bewertungen wird gefragt, ob ein Modell eine Aufgabe verfolgen, Tools verwenden, Ausgaben überprüfen, Fehler beheben und nützliche Arbeiten abschließen kann. Die 82,7 % Terminal-Bench 2.0-Zahl von GPT-5.5 ist ein starkes Signal für diese Kategorie.
Auch Claude Opus 5 ist hier relevant, da es auf der Live-Modellseite von Anthropic nun über den älteren Opus-Einträgen aufgeführt wird. Die Seite sollte als aktuelle Produktreferenz und nicht als Ersatz für eine vergleichbare Benchmark-Reihe eines Drittanbieters betrachtet werden.
Hier kommt es auch auf die Wahl des Werkzeugs an. Cursor, Claude Code, Terminalagenten im Codex-Stil und benutzerdefinierte Gerüste können das Ergebnis verändern. Die damit verbundene Frage ist nicht nur „Welches Modell?“ aber „Welches Modell in welchem Workflow?“ Um die Produktivitätsfalle dahinter zu erfahren, lesen Sie KI-Codierungstools: 19 % langsamer, obwohl sie sich schneller fühlen.
Was sich seit Februar 2026 geändert hat
In der Februarversion dieses Artikels wurden Claude Opus 4.5, GPT-5.2, Gemini 2.5 Pro und DeepSeek V3.1 als zentrale Vergleichssätze behandelt. Für eine Benchmark-Seite 2026 ist das nicht mehr aktuell genug.
Hier ist das Update vom Juni 2026:
| Februar-Einrahmung | Aktualisierung im Juni 2026 |
|---|---|
| Claude Opus 4.5 als Premium-Codierungsführer | Claude Opus 5 wird jetzt als aktuelles anthropisches Grenzmodell für Codierung und Agenten aufgeführt |
| GPT-5.2 als wichtigstes OpenAI-Argumentationsmodell | GPT-5.5 verankert jetzt den OpenAI-Vergleich für Benchmarks für terminales und wissenschaftliches Denken |
| Gemini 2.5 Pro als Kontextfenster-Story | Gemini 3.1 Pro ist das aktuelle Google-Modellkartenziel; Überprüfen Sie den Live-Kontext-Anspruch von Anthropic separat |
| DeepSeek V3.1 als Wertanwärter | DeepSeek V3.2 und V3.2-Speciale sind jetzt die relevanten Argumentations-/Codierungsreferenzen |
| Ein „bestes Modell“-Anspruch | Aufgabenspezifischer Vergleich zwischen SWE-Bench, Aider, LiveCodeBench, Terminal-Bench und mathematischem Denken |
Auch die Geschichte des offenen Modells änderte sich. Kimi K2.5-, Qwen-, GLM-, MiniMax- und DeepSeek-Einträge erscheinen jetzt oft genug in öffentlichen Bestenlisten, dass sie als echte Optionen und nicht als Kuriositäten behandelt werden sollten. Der Moonshot-Winkel wird separat in Verbose AI Beats Fast AI: Moonshot K2 $1,172 Paradox behandelt.
Welches Modell sollten Sie verwenden?
| Anwendungsfall | Bester Ausgangspunkt | Warum |
|---|---|---|
| Echte Repo-Fehlerbehebung | Claude-Familie oder Gemini/GPT-Systeme mit starken SWE-Bench-Gerüstergebnissen | SWE-Bench belohnt Repo-Verständnis, Tests und Patch-Validierung |
| Patch-intensive IDE-Bearbeitung | GPT-5 hoch/mittel in Workflows im Aider-Stil | Aider legt Wert auf saubere Unterschiede und mehrsprachige Bearbeitung |
| Terminallastiges autonomes Arbeiten | Agent-Setups im GPT-5.5- oder Claude Opus 5-Stil | Terminal-Bench und Agentenstartpositionierung sind wichtiger als die automatische Vervollständigung |
| Mathematik und wissenschaftliches Denken | GPT-5.5, DeepSeek V3.2-Speciale, Gemini 3.1 Pro | Nutzen Sie FrontierMath, GPQA, MMLU-Pro und multimodalen Argumentationskontext zusammen |
| Budgetsensitive Codierung | Optionen für DeepSeek V3.2, Kimi K2.5, Qwen/GLM-Familie | Die öffentlichen Bewertungen sind mittlerweile stark genug, um ernsthafte Piloten zu rechtfertigen |
| Professionelle Arbeit mit großem Kontext | Claude Opus 5 oder Gemini 3.1 Pro | Kontextfenster und multimodale/Dokumentenverarbeitung können die Rohcodierungswerte dominieren |
Für die meisten Teams ist der beste Stack Hybrid:
- Verwenden Sie ein schnelles, günstigeres Modell für routinemäßige Bearbeitungen und Erklärungen.
- Verwenden Sie ein stärkeres Argumentationsmodell für schwere Fehler, Architektur und mehrstufige Agentenausführungen.
- Validieren Sie jede Modellausgabe mit Tests, Überprüfung und Beobachtbarkeit.
- Überprüfen Sie die Benchmark-Daten monatlich erneut, da sich die öffentliche Bestenliste schneller ändern kann als Ihr Beschaffungszyklus.
Benchmark-Vorbehalte
Methodik und Quellenebenen
Jede Bewertung auf dieser Seite ist nach Quellklasse gekennzeichnet: vom Anbieter gemeldete Veröffentlichungsdaten, Bestenlistendaten von Drittanbietern oder ein öffentlicher Benchmark-Snapshot. Die Ergebnisse der Anbieter sind hilfreich, um die vom Hersteller gewählte Konfiguration zu verstehen. Ergebnisse von Drittanbietern sind für den modellübergreifenden Kontext nützlicher; Es gibt auch keine Garantie für die Leistung in Ihrem Repository.
Für jede Zeile werden bei der Überprüfung die Modellversion, das Datum des Datensatzes oder der Rangliste, das Gerüst, der Werkzeugzugriff, die Erfolgsmetrik und die Reproduzierbarkeit des Ergebnisses erfasst. Der Leitfaden zur KI-Benchmark-Methodik enthält die vollständige Evidence-Ledger-Vorlage und Aktualisierungsregeln. Wenn eine Quelle keine vergleichbare Zahl veröffentlicht, verwendet die Tabelle absichtlich eine qualitative Bezeichnung, anstatt eine Bewertung zu erfinden.
Benchmark-Scores sind nützlich, aber sie sind kein alleiniger Leitfaden für den Käufer.
Scaffolding verändert die Punktzahl. SWE-Bench-Einträge umfassen oft ein Modell plus ein Agentensystem. Abrufen, Dateiauswahl, Werkzeugausführung, Wiederholungsversuche und Testumgebungen können das Ergebnis erheblich beeinflussen.
Aider, SWE-Bench und LiveCodeBench messen unterschiedliche Arbeit. Ein Modell kann bei Code-Bearbeitungen hervorragend und bei der echten Repo-Fehlerbehebung schwächer sein. Ein anderer kann Algorithmenwettbewerbe lösen, hat aber mit unordentlichem Produktionscode zu kämpfen.
Von Anbietern eingeführte Ergebnisse und öffentliche Bestenlisten sollten nicht blind zusammengeführt werden. Behalten Sie sie in separaten Zeilen, es sei denn, die Aufgabe, der Datensatz und die Bewertungsumgebung sind identisch.
Latenz und Kosten sind in vielen Zusammenfassungen unsichtbar. Ein Modell, das mit starker Argumentation eine höhere Punktzahl erzielt, ist möglicherweise die falsche Wahl für die Echtzeit-IDE-Nutzung.
Frische ist wichtig. In einem Benchmark-Artikel für 2026 sollte das Datum der Datenüberprüfung genannt werden. Wenn diese Seite zum Zeitpunkt des Lesens mehr als einen Monat alt ist, überprüfen Sie die neueste Bestenliste, bevor Sie eine ernsthafte Modellentscheidung treffen.
Fazit
Der beste LLM-Benchmark-Vergleich 2026 ist nicht „Claude vs. GPT vs. Gemini vs. DeepSeek“ als Einzelkampf. Es ist eine Karte:
- GPT-5.5 scheint in den OpenAI-Startdaten vom Juni 2026 für Terminal-Agent- und wissenschaftliche Argumentationsaufgaben am stärksten zu sein.
- Claude Opus 5 ist die neueste Anthropic-Version für Codierung, Agenten und professionelle Arbeit. Überprüfen Sie die Live-Auswertungsdetails, bevor Sie sie numerisch vergleichen.
- Gemini 3.1 Pro ist Googles aktuelles Modellkartenziel für multimodales Denken.
- DeepSeek V3.2 ist der Wertanwärter, der jetzt ernsthafte Coding- und Reasoning-Piloten verdient.
- Aider, SWE-bench, LiveCodeBench und Terminal-Bench beantworten unterschiedliche Fragen. Verwenden Sie daher den Benchmark, der zu Ihrem Workflow passt.
Wenn Sie sich nur an eine Regel erinnern: Wählen Sie den Benchmark, der Ihrer tatsächlichen Aufgabe ähnelt, und wählen Sie dann das Modell.